GPT-6.1 Sol von OpenAI (Reasoning high) schreibt derzeit am besten auf Deutsch, mit einer Bewertung von 97,0. Unter den Modellen, die auf dem eigenen Rechner laufen, führt Gemma 4 31B von Google (Q8_0, Reasoning an) mit 68,7.
Das KI-Schreibranking misst, wie gut führende KI-Modelle auf Deutsch schreiben. Grundlage ist ein gemeinsamer Korpus deutschsprachiger Schreibaufgaben. Die Antworten auf dieselbe Aufgabe werden ohne Modellnamen verglichen; aus den Urteilen entsteht eine eigene Rangliste für Deutsch.
107 Modelle, verglichen in 115.560 blinden Urteilen, Stand 13. Oktober 2026.
Die 10 besten Modelle
Die zehn besten Modelle für deutsche Texte
#
Modell
Bewertung
1
GPT-6.1 Sol 💡 high
97,0
2
Claude Opus 5.5 💡 adaptive high
96,4
3
GPT-6 Astra 💡 high
95,6
4
Claude Fable 5.1 💡 adaptive high
95,5
5
Claude Opus 5 💡 adaptive high
95,1
6
Claude Fable 5 💡 adaptive high
94,6
7
Kimi K3 💡 enabled
93,2
8
Muse Spark 1.2 💡 high
90,6
9
GPT-6 Sol 💡 high
90,3
10
GPT-5.6 Sol 💡 high
90,1
Diese Bewertung ist keine Prozentnote: 50 bedeutet, dass ein Modell das durchschnittliche Modell auf Deutsch schätzungsweise in der Hälfte der Duelle schlägt.
Größe der getesteten GGUF-Datei, Bild-Encoder eingeschlossen, falls vorhanden (GB, dezimal, wie in LM Studio) · +128K: Datei + Kontext-Cache bei 131.072 Token (128K), F16- oder Q8-Cache je nach Auswahl, Flash Attention aktiv (GB) · +256K: Dasselbe bei 262.144 Token (256K), begrenzt auf das native Kontextfenster (GB)
Das beste lokale Modell für Ihren Speicher
Die am besten schreibende Variante, die in den Grafikspeicher oder den gemeinsamen Speicher passt, bei kurzem Kontext. Details, Geschwindigkeiten und Alternativen auf der Seite Lokale KI.
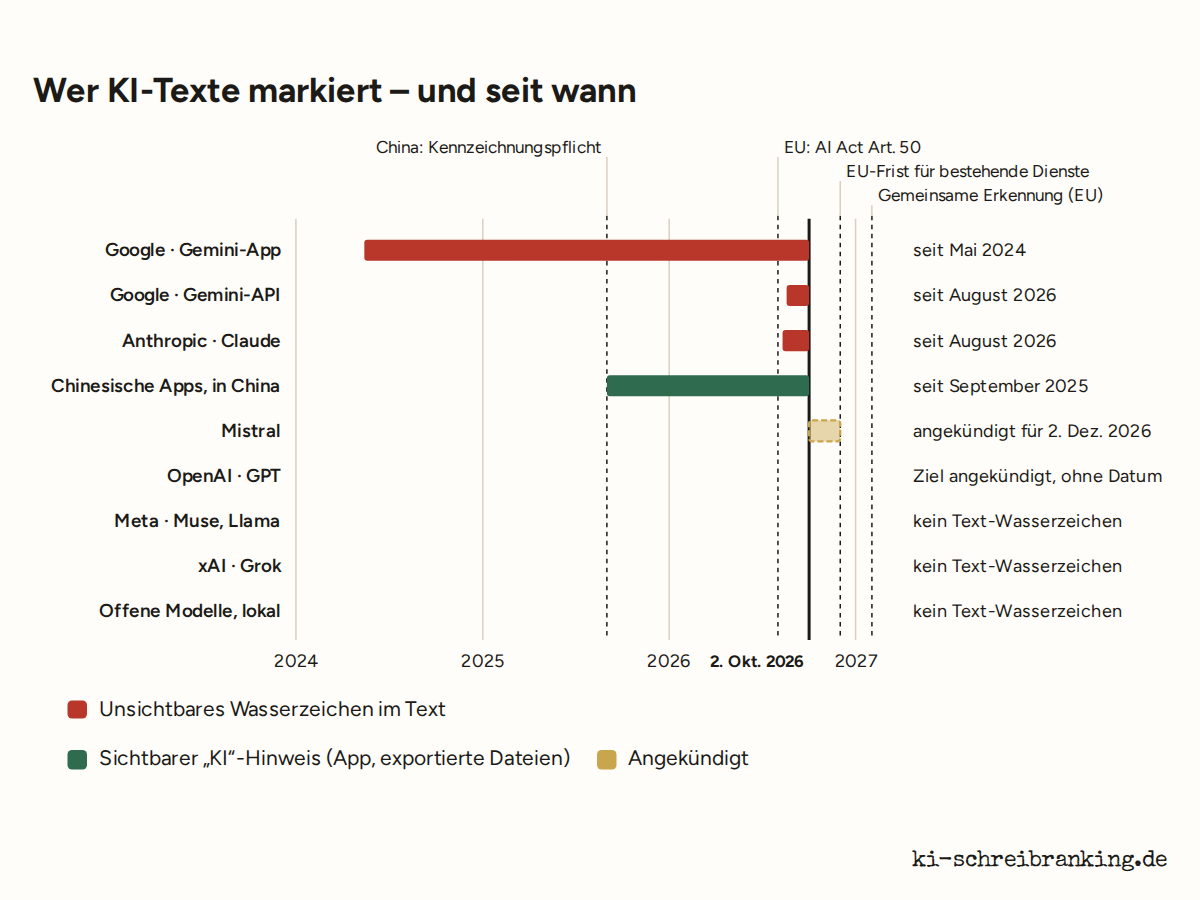
Seit diesem Sommer tragen Texte von Claude und Gemini ein unsichtbares Zeichen. Texte von ChatGPT, Grok, Mistral, Meta AI und lokal betriebenen Modellen tragen keines, chinesische Dienste begnügen sich mit einem sichtbaren Hinweis. Prüfen kann einen Text heute aber niemand außerhalb der Anbieter.
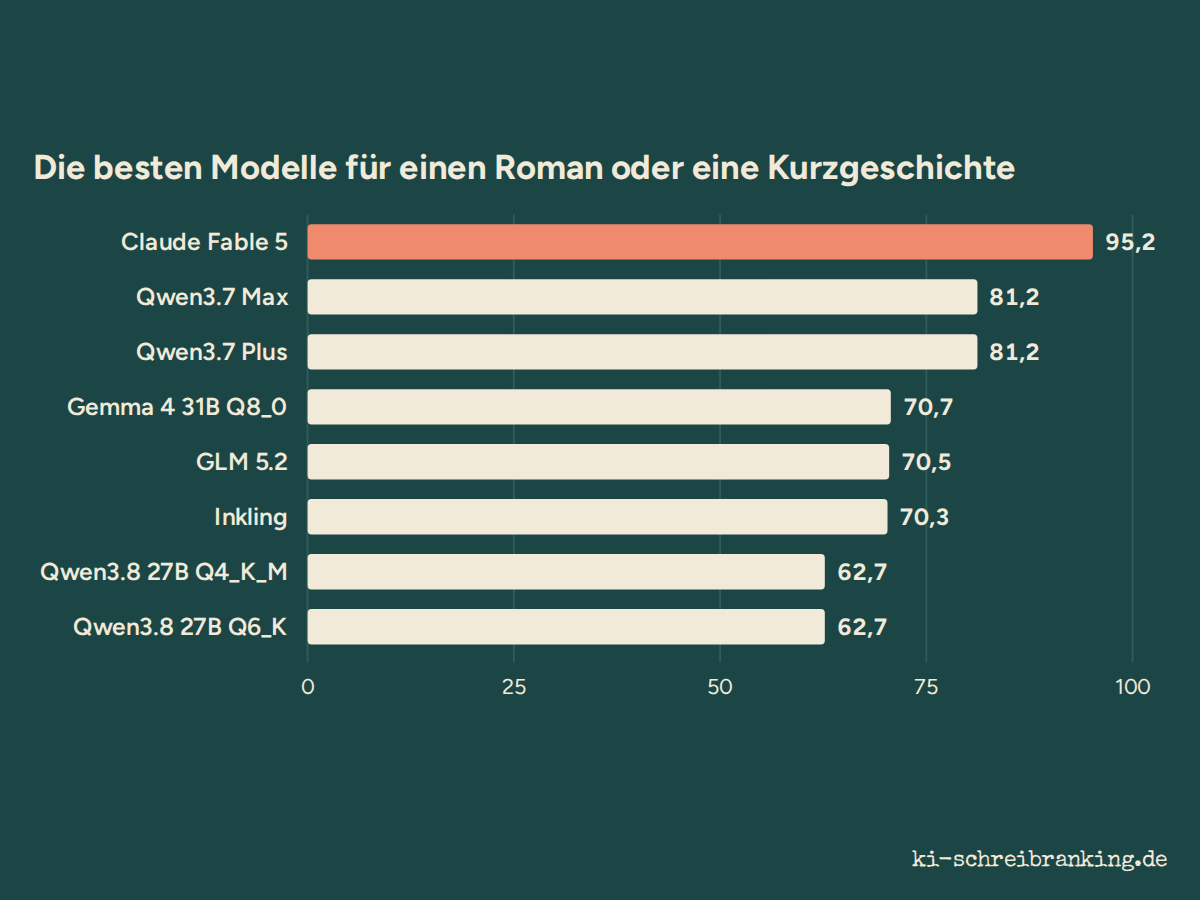
Die Rangliste hat einen Sieger; Ihre Texte haben viele. Allein auf den Duellen einer Textsorte gewinnt Claude Fable 5 Fiktion und Erklärung, Claude Opus 5 persönliche Briefe, und bei Bewerbungen liegen Claude Fable 5 und GPT-5.6 Sol gleichauf. Ein einfacher Leitfaden, Aufgabe für Aufgabe, mit der besten Datei für den eigenen Rechner.
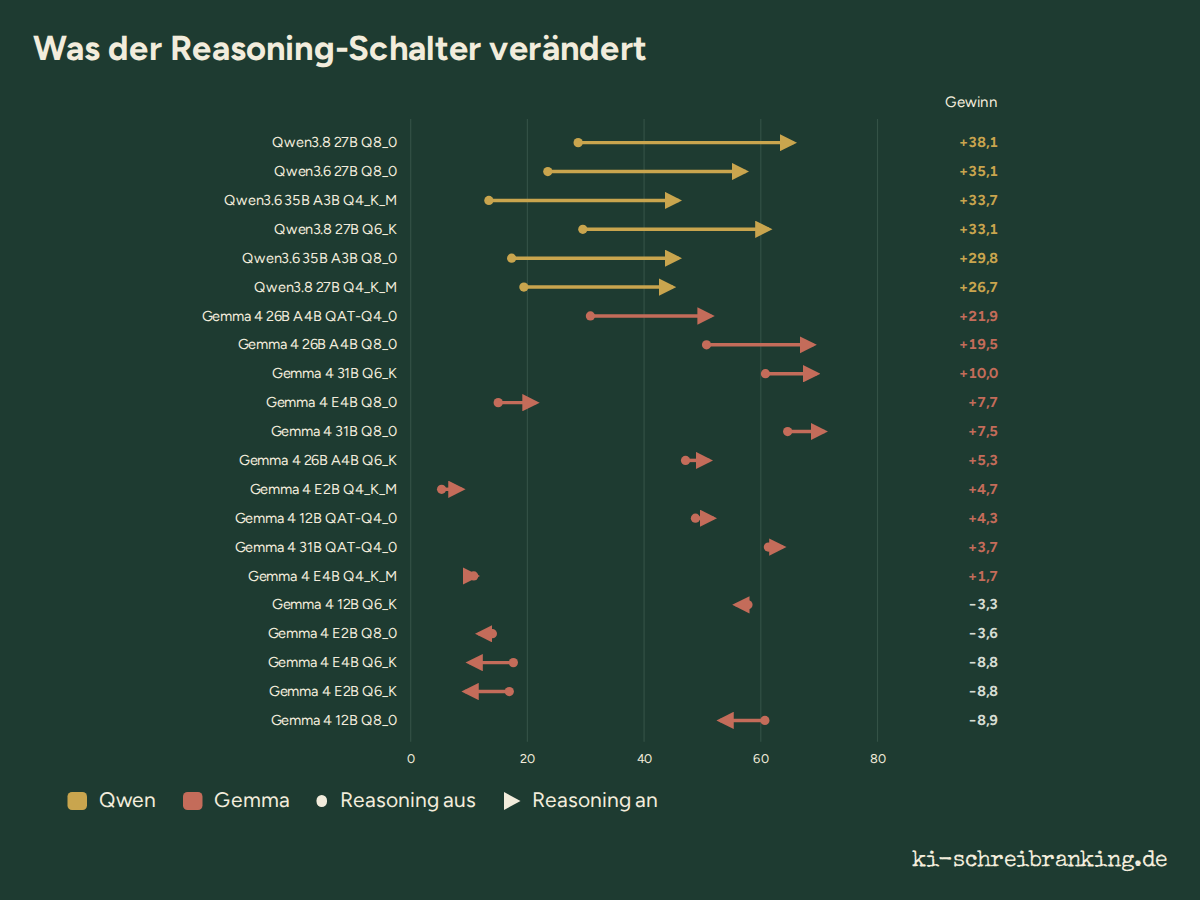
Dieselbe Datei, dieselben Aufgaben, ein Schalter. Über 21 lokale Varianten bringt eingeschaltetes Reasoning der Qwen-Familie im Schnitt 33 Punkte und den Gemma-4-Modellen ab 12B sieben; die kleinen Gemma E2B und E4B verlieren im Schnitt einen Punkt. Qwen3.8 27B Q8_0 gewinnt 38 Punkte, so viel wie kein anderes Modell auf Deutsch.
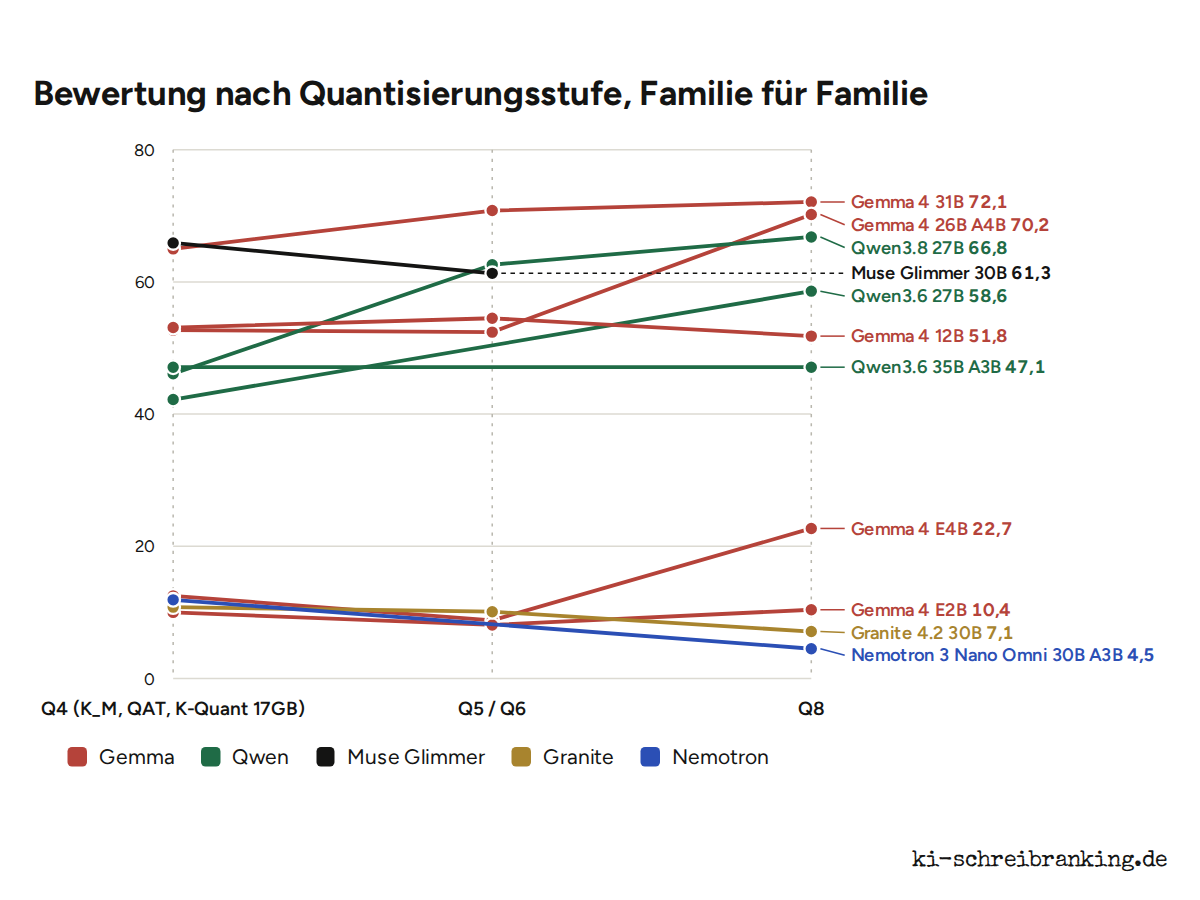
Dasselbe Modell, drei Dateien, drei Bewertungen. Auf Deutsch verliert Qwen3.8 27B 21 Punkte zwischen Q8_0 und Q4_K_M, Gemma 4 26B A4B 18 Punkte, während Gemma 4 31B in Q6 fast so gut schreibt wie in Q8 und Qwen3.6 35B A3B in Q4 und Q8 exakt gleich abschneidet. Eine Faustregel gibt es nicht, nur Messungen.
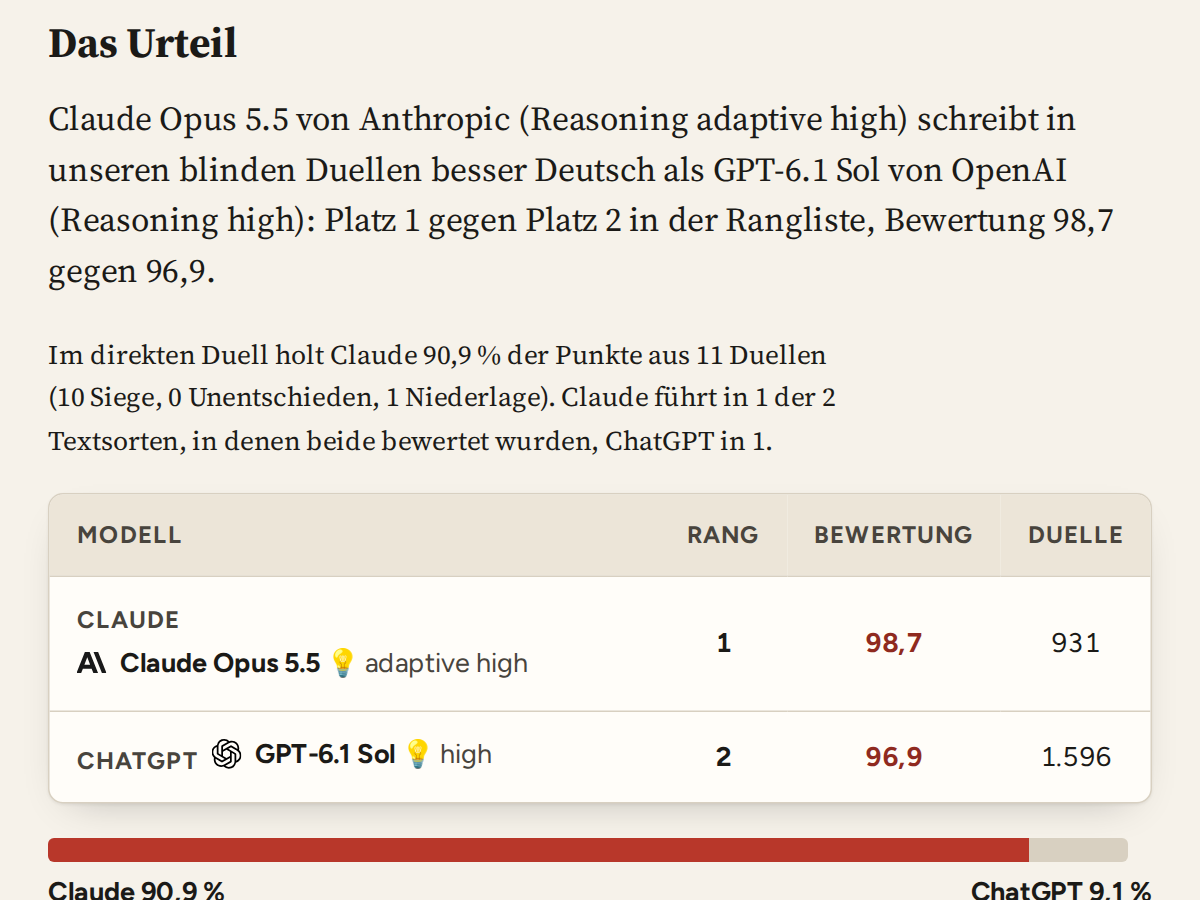
Die beiden meistgefragten Assistenten, auf denselben deutschen Aufgaben in blinden Duellen beurteilt: wer besser schreibt, um wie viel, und bei welchen Textsorten. Mit jeder Aktualisierung der Rangliste neu berechnet.
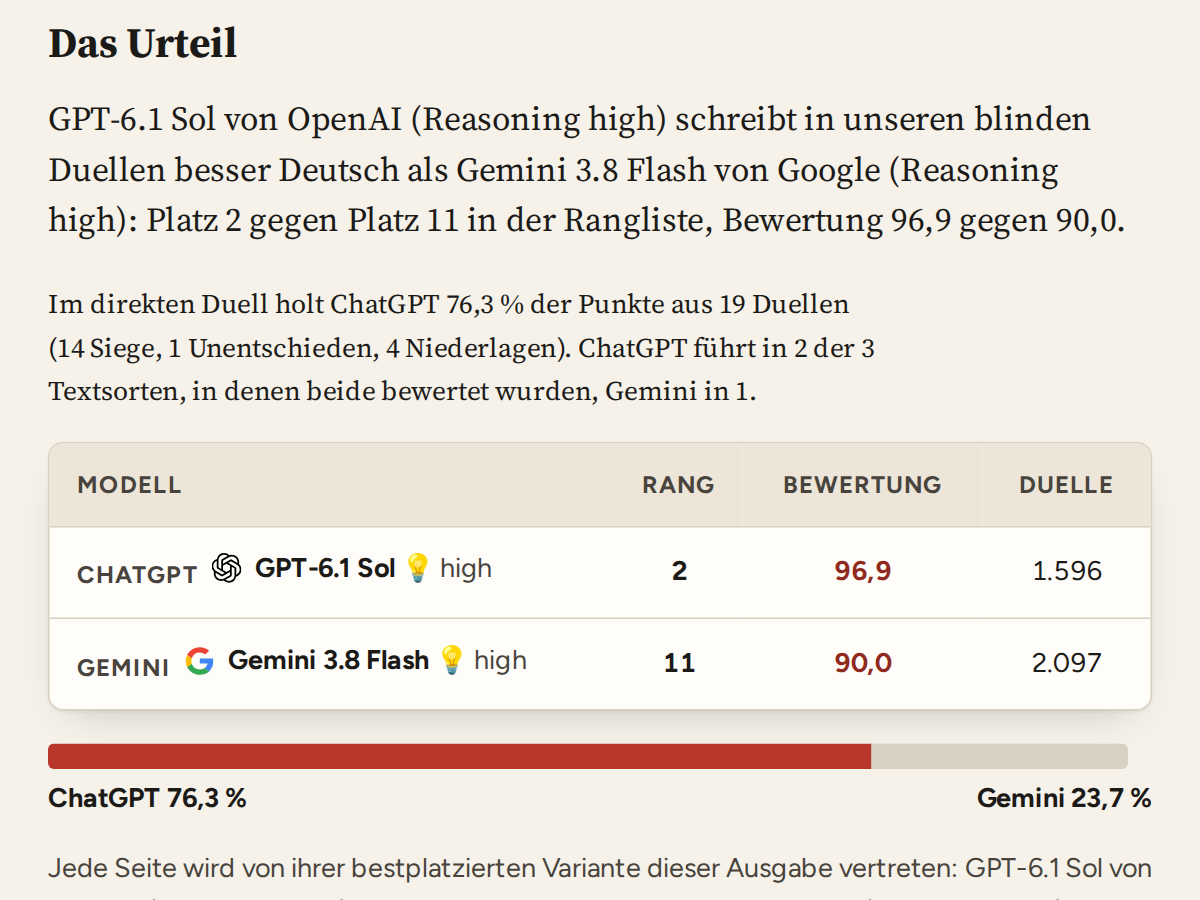
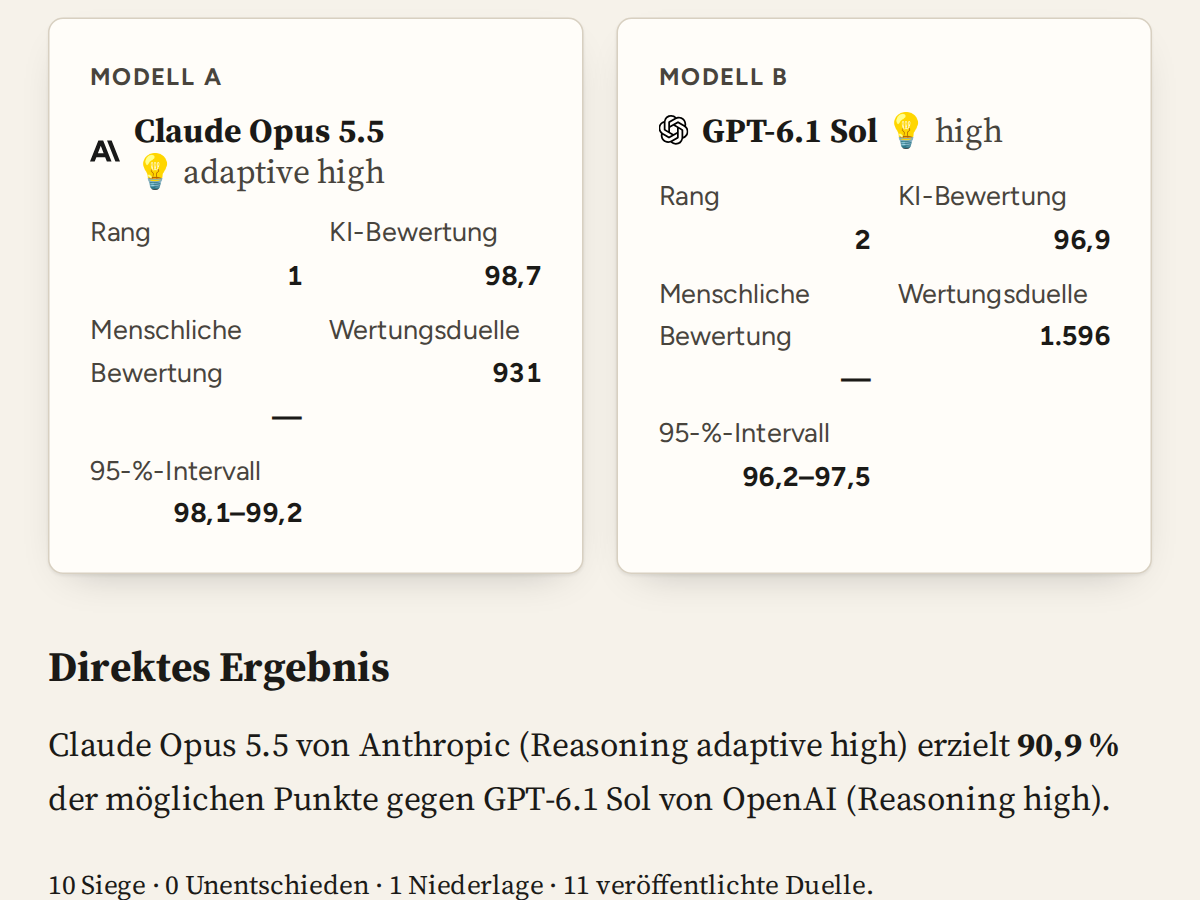
Das beste Modell von OpenAI gegen das beste von Google, auf denselben deutschen Aufgaben, in blinden Duellen: wer in der Rangliste vorn liegt, wie die direkten Duelle ausgingen und wo jedes stärker ist.
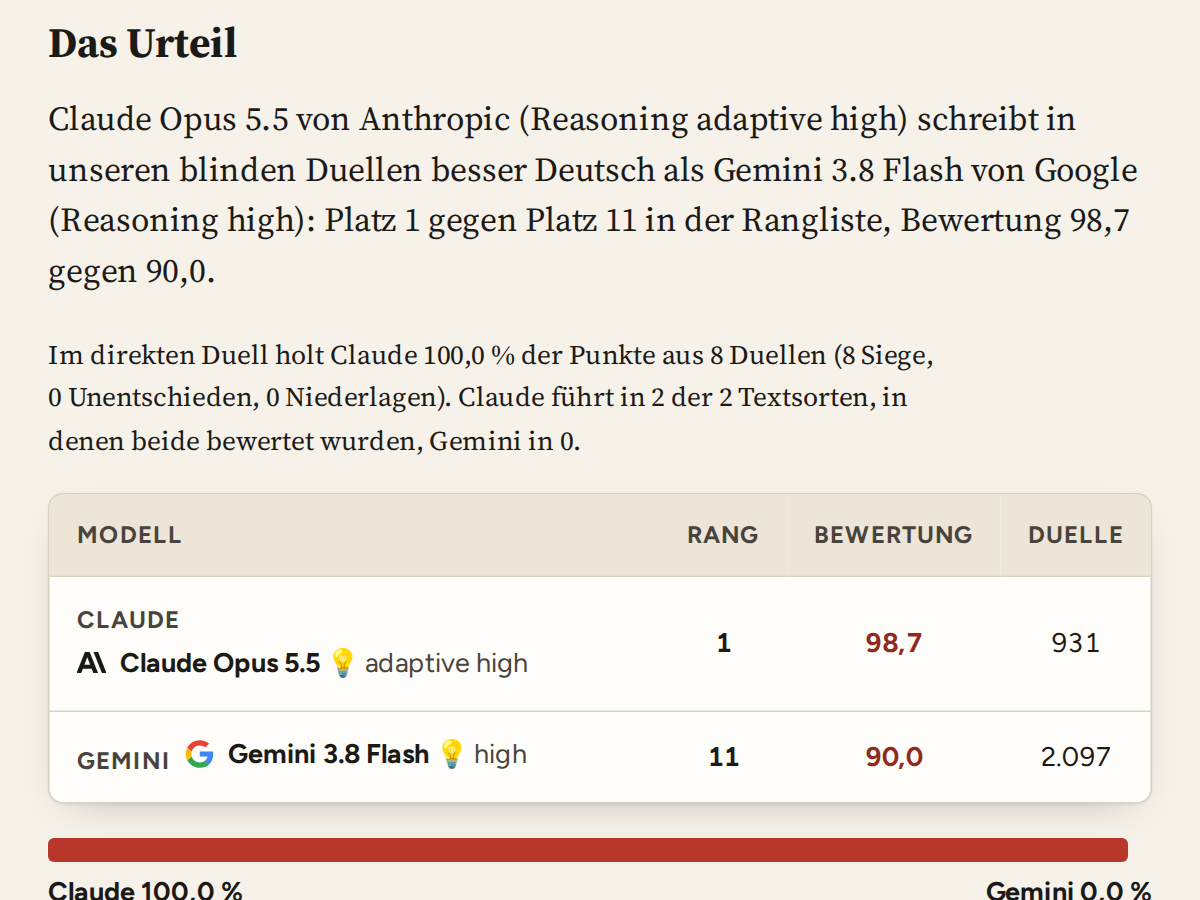
Das beste Modell von Anthropic gegen das beste von Google, auf denselben deutschen Aufgaben, in blinden Duellen: der Abstand in der Rangliste, die direkte Bilanz und die Textsorten, in denen Gemini am nächsten kommt.
Wer dieses Ranking betreibt, auf welchen Rechnern, und die Grundsätze hinter den blinden Duellen.
Die Rangliste bewertet ausschließlich die Schreibqualität. Die Aufgaben entstehen direkt in der geprüften Sprache, und die Modellnamen bleiben bis zum Urteil verborgen, damit ihr Ruf die Bewertung nicht beeinflusst. Diese Website ist ein persönliches Projekt. Kein Modellentwickler bezahlt mich, und ich habe keinen Grund, ein Modell zu bevorzugen.