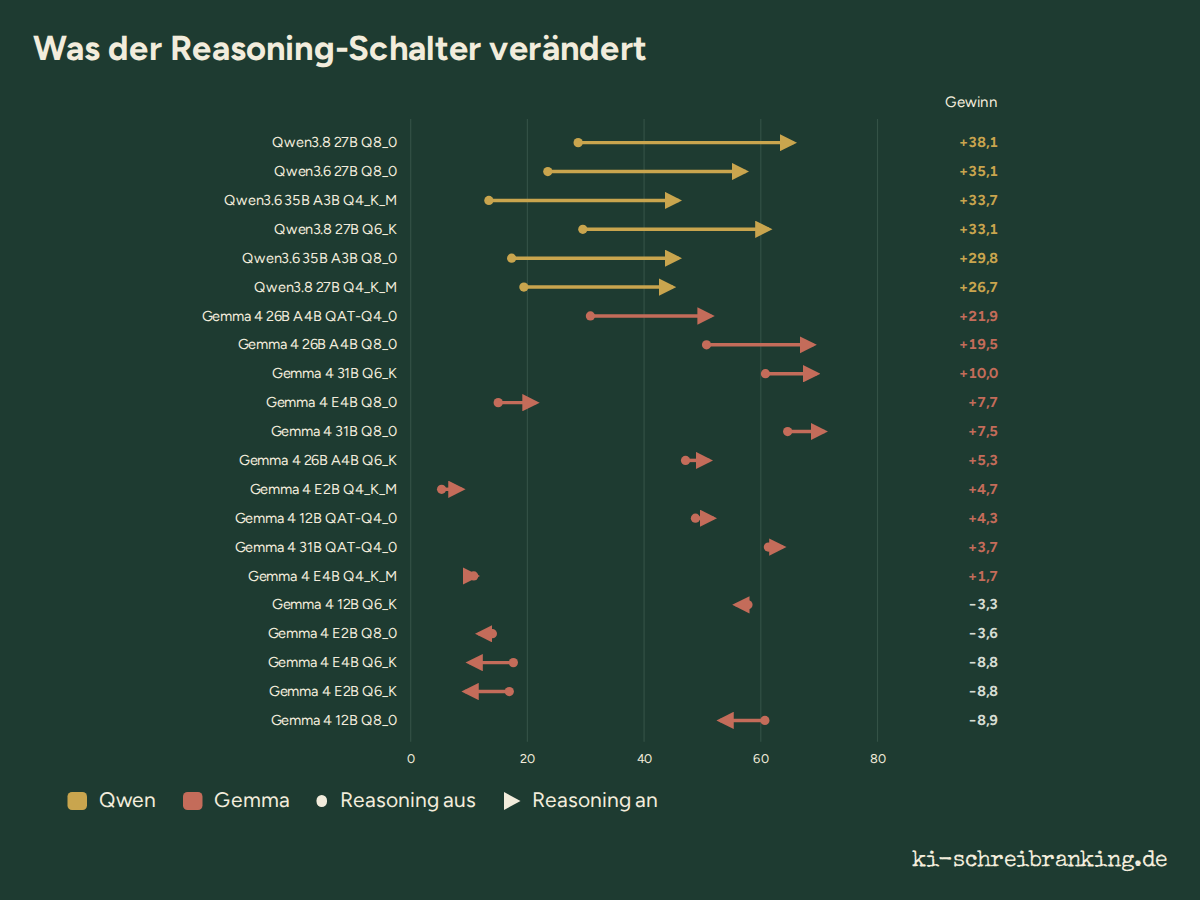
Die vollständige Rangliste
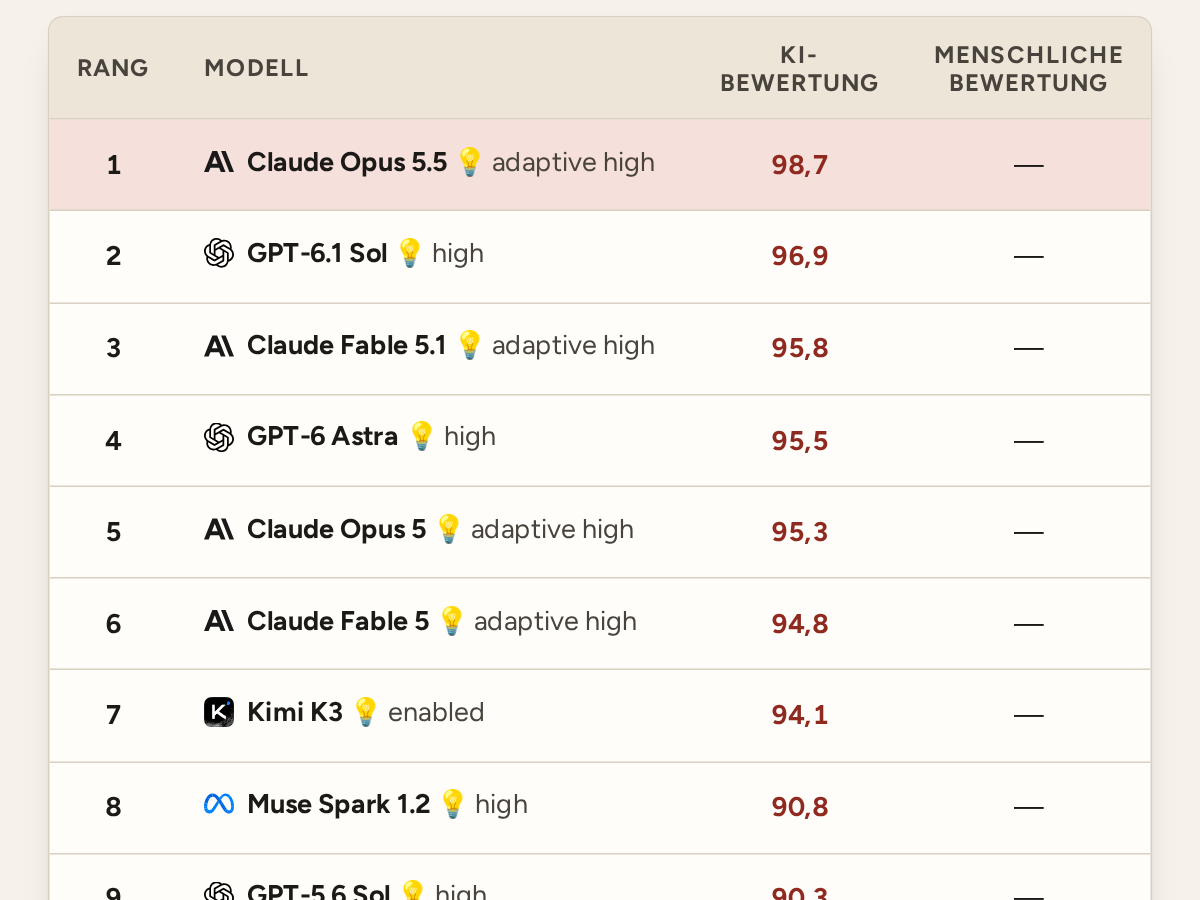
Alle Modelle nach ihrer Schreibqualität auf Deutsch, mit Filtern nach Textsorte, Anbieter, Größe, Reasoning und Quantisierung, dazu die Duellmatrizen.
Neue Modelle bei ihrem Einstieg ins Ranking, ihr Platz gegenüber dem Vorgänger, neue Analysen und die Meilensteine des Projekts.
111.252 gewertete Urteile
108 gerankte Modelle
noch 13.748 bis 125.000
Kumulierte Werte der deutschen Ausgabe, Tag für Tag.
Ränge und Punktzahlen sind die von heute: Sie werden mit jedem neuen Urteil neu berechnet und beim Einstieg eines Modells nicht eingefroren.

MiniMax M3.1 Flash. Heute Platz 78 von 108, mit 24,2 Punkten.

Ling 3.1 Flash. Heute Platz 39 von 108, mit 65,1 Punkten.

Mistral Large 4. Heute Platz 30 von 108, mit 73,6 Punkten.
Nemotron 3 Ultra. Heute Platz 56 von 108, mit 52,7 Punkten.
Nemotron 3.5 Lightning. Heute Platz 86 von 108, mit 16,7 Punkten.

Claude Haiku 5.5. Heute Platz 19 von 108, mit 83,4 Punkten.
100.000
Erreicht 78 Tage nach dem ersten Duell, 8 Tage nach der Marke von 75.000.
Bisher verglichen die meisten Duelle persönliche Nachrichten. Neue Duelle verteilen sich auf die zehn Kategorien (Briefe, Artikel, Fiktion, Reden, Berichte …), beginnend mit den am wenigsten abgedeckten: Das Ranking bildet nach und nach alle Textarten ab.
Muse Spark 1.3, das im Ranking immer weiter zurückfiel, urteilt nicht mehr; seine bisherigen Urteile bleiben veröffentlicht. Claude Opus 5.5 übernimmt seinen Anteil, die Duelle kommen im selben Tempo.
Im Duell und auf den Vergleichsseiten zeigen die Antworten jetzt Fettdruck, Zwischenüberschriften und Listen statt roher Sternchen und Rauten: Man bewertet den Text so, wie ihn ein Leser sehen würde.
Etwa jedes zwanzigste Urteil stammte von einem Juror, der sein eigenes Modell bewertete, und der bevorzugte sich tendenziell selbst: bei manchen Modellen um bis zu fünf Punkte. Diese Urteile bleiben auf der Juroren-Seite veröffentlicht, zählen aber nicht mehr im Ranking, und kein Juror bekommt mehr sein eigenes Modell vorgelegt.

GPT-6.1 Sol. Heute Platz 1 von 108, mit 97,0 Punkten. Das sind 6,6 Punkte mehr als beim Vorgänger GPT-6 Sol (Platz 9, 90,4). Direkte Duelle gegen ihn gewonnen: 19 von 21 (90 %).
100
Mit Claude Sonnet 5.5, 73 Tage nach dem ersten Duell.

Aion 3.5. Heute Platz 25 von 108, mit 78,5 Punkten. Das sind 9,8 Punkte mehr als beim Vorgänger Aion 3.0 (Platz 34, 68,7).
Claude Sonnet 5.5. Heute Platz 15 von 108, mit 88,6 Punkten. Das sind 9,4 Punkte mehr als beim Vorgänger Claude Sonnet 5 (Platz 24, 79,2).
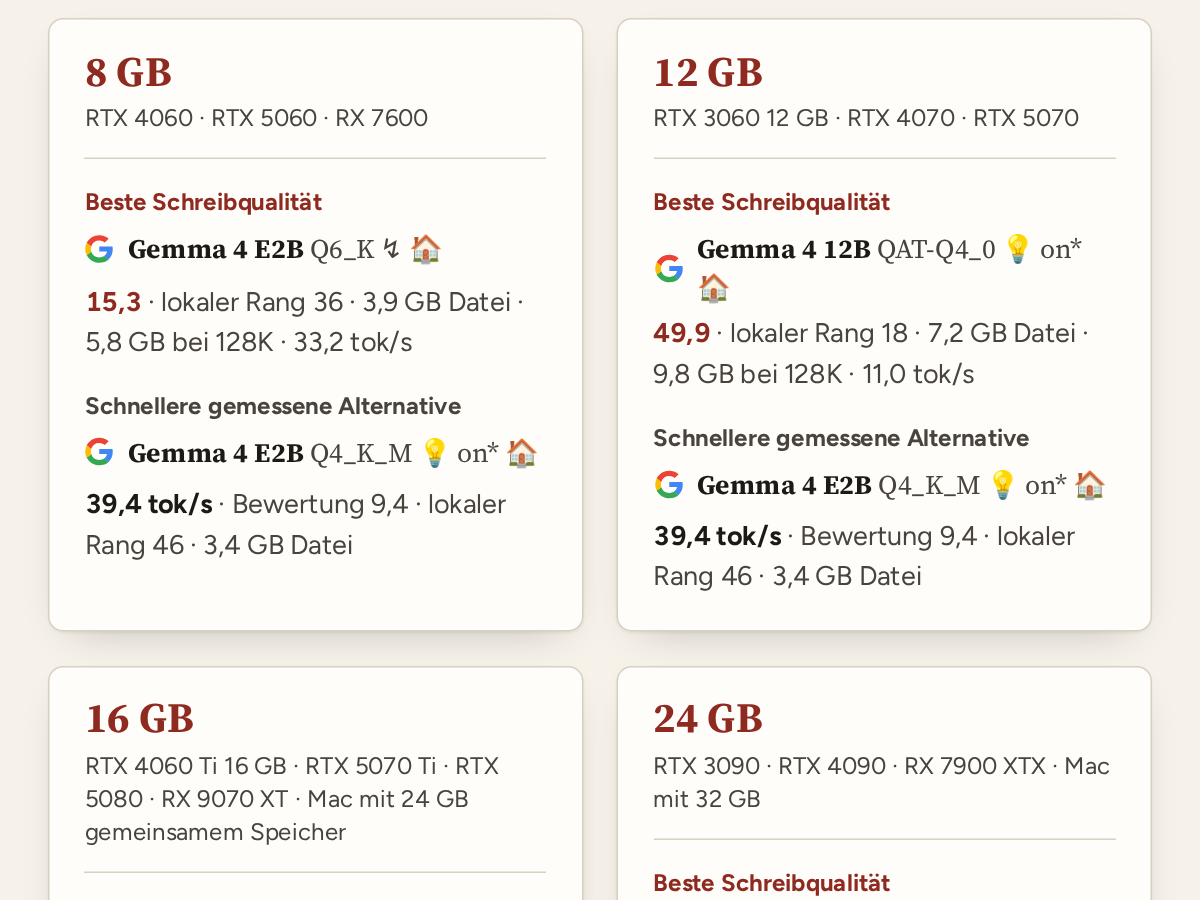
Das Ranking lokaler Modelle zeigt den Speicherbedarf für die Datei und für 128K oder 256K Kontext, in GGUF oder MLX und mit F16- oder Q8-Cache. Schaltflächen über jedem Ranking wechseln zwischen den neuesten Modellen, der Vorgängergeneration und älteren.
75.000
Erreicht 70 Tage nach dem ersten Duell, 12 Tage nach der Marke von 50.000.
Claude Opus 5.5. Heute Platz 2 von 108, mit 96,4 Punkten. Das sind 1,3 Punkte mehr als beim Vorgänger Claude Opus 5 (Platz 5, 95,1).
GPT-6 Luna. Heute Platz 23 von 108, mit 80,0 Punkten. Das sind 2,2 Punkte mehr als beim Vorgänger GPT-5.6 Luna (Platz 27, 77,8).
GPT-6 Sol. Heute Platz 9 von 108, mit 90,4 Punkten. Gleichauf mit dem Vorgänger GPT-5.6 Sol (Platz 10, 90,2).
Die neuesten Modelle von Anthropic und OpenAI übernehmen neben Muse Spark 1.3 das Urteilen. Jedes Urteil vergleicht weiterhin zwei anonyme Texte zur selben Aufgabe.

Agnes 3.0 Flash. Heute Platz 80 von 108, mit 22,8 Punkten.

Grok 4.7. Heute Platz 14 von 108, mit 88,7 Punkten. Das sind 41,0 Punkte mehr als beim Vorgänger Grok 4.6 (Platz 62, 47,7). Direkte Duelle gegen ihn gewonnen: 9 von 11 (82 %).

MiMo V2.6 Flash. Heute Platz 75 von 108, mit 29,8 Punkten.
MiMo V2.6 Pro. Heute Platz 38 von 108, mit 66,1 Punkten. Das sind 6,1 Punkte mehr als beim Vorgänger MiMo V2.5 Pro (Platz 46, 60,0). Direkte Duelle gegen ihn gewonnen: 17 von 35 (49 %).
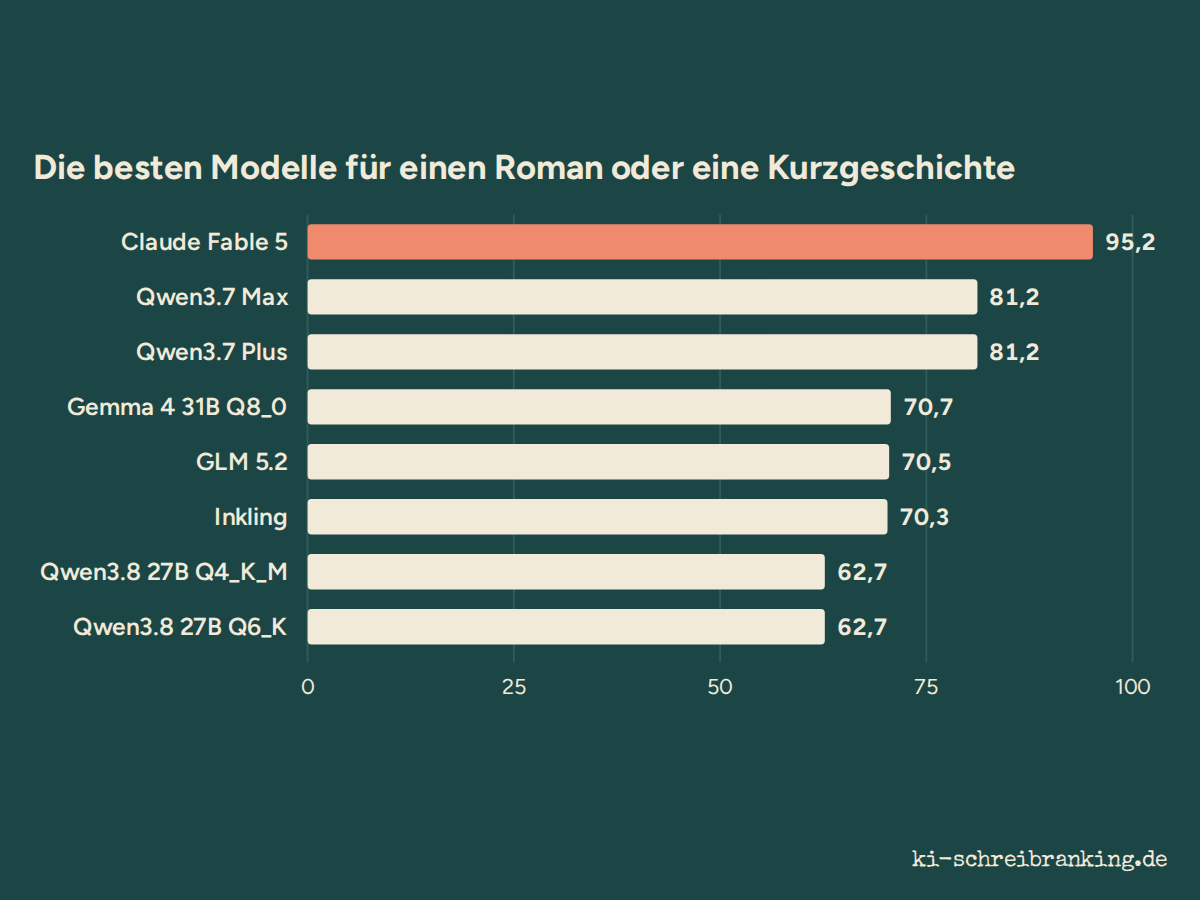 Welche KI für Roman, E-Mail, Bewerbung oder Hausarbeit? Das beste Modell wechselt mit der Textsorte
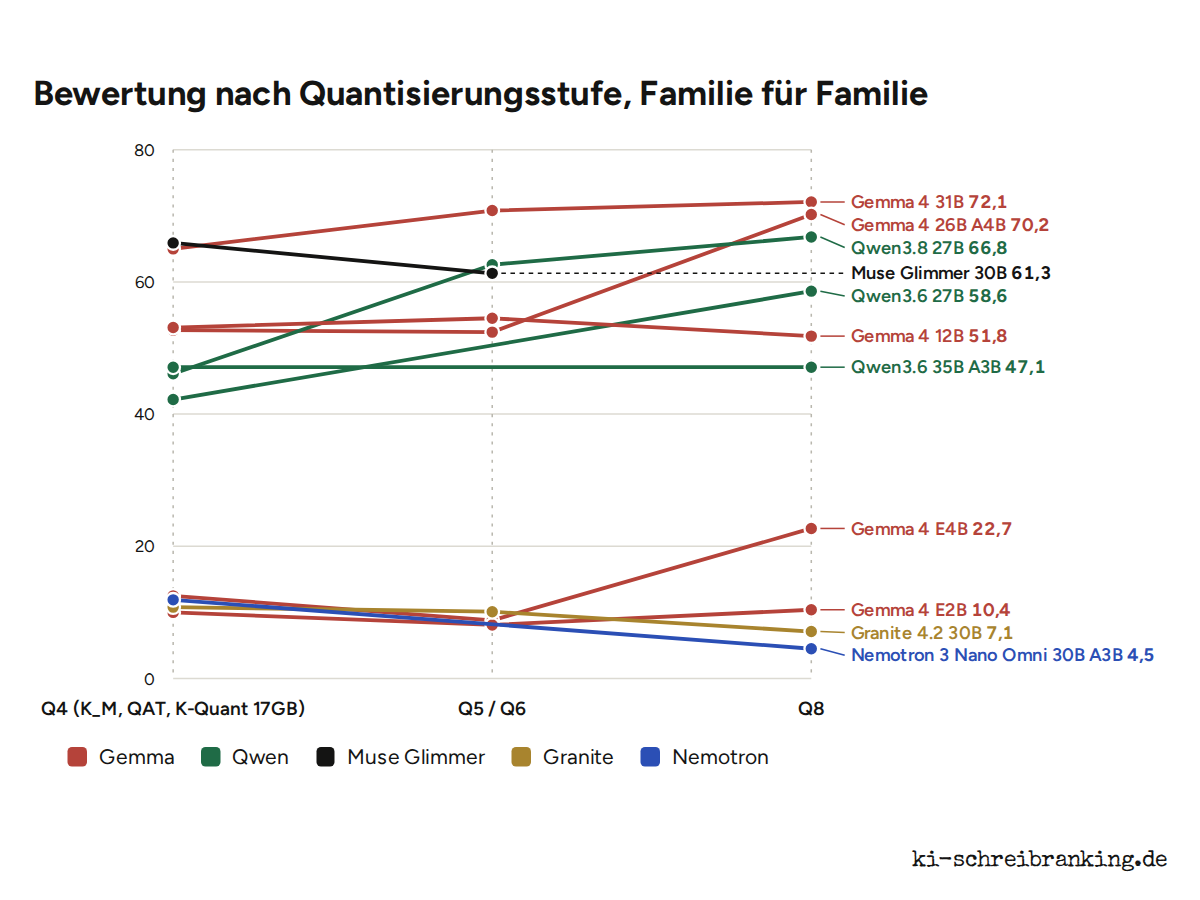 Q4, Q6 oder Q8: Quantisierung kostet bei manchen Modellen nichts und bei anderen zwanzig Punkte
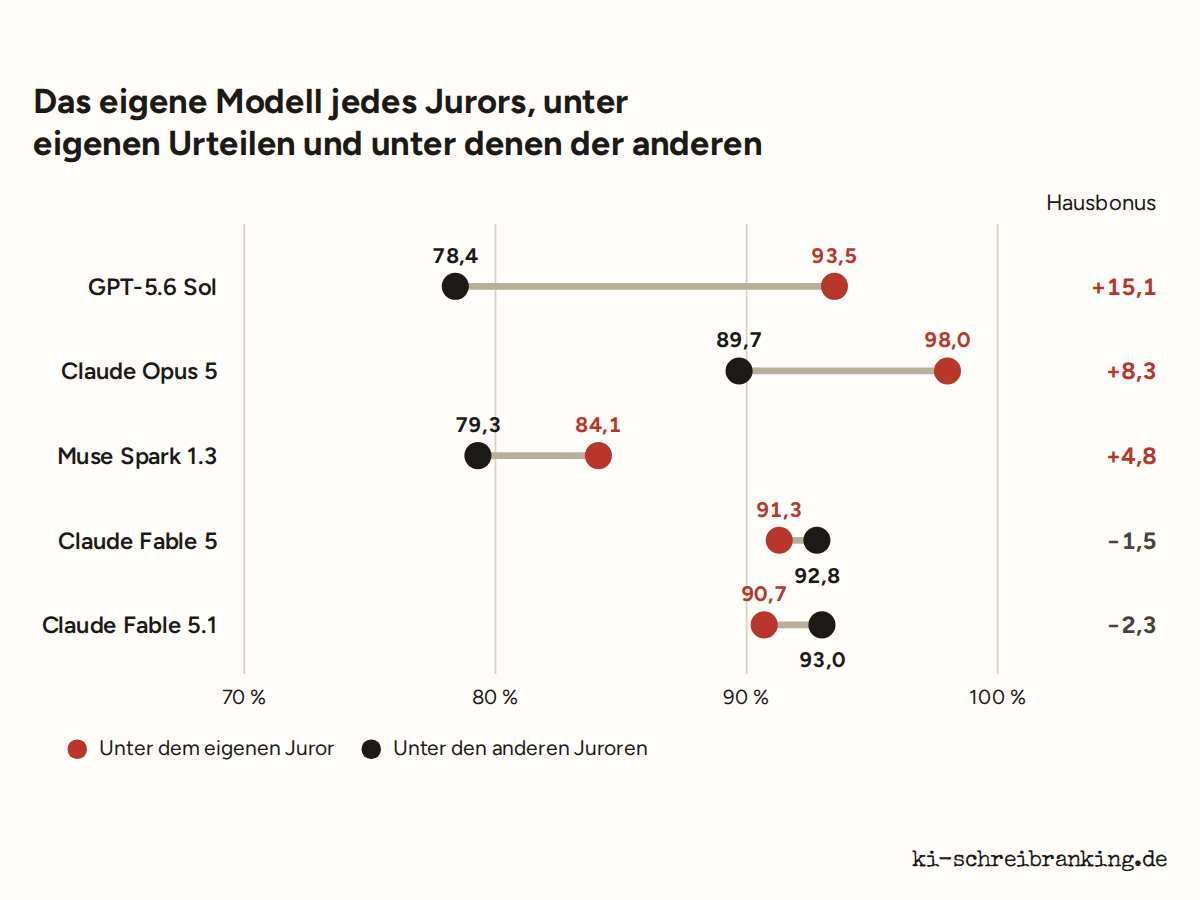 Bevorzugen KI-Juroren das eigene Modell? Zwei von fünf tun es, um bis zu 15 Punkte
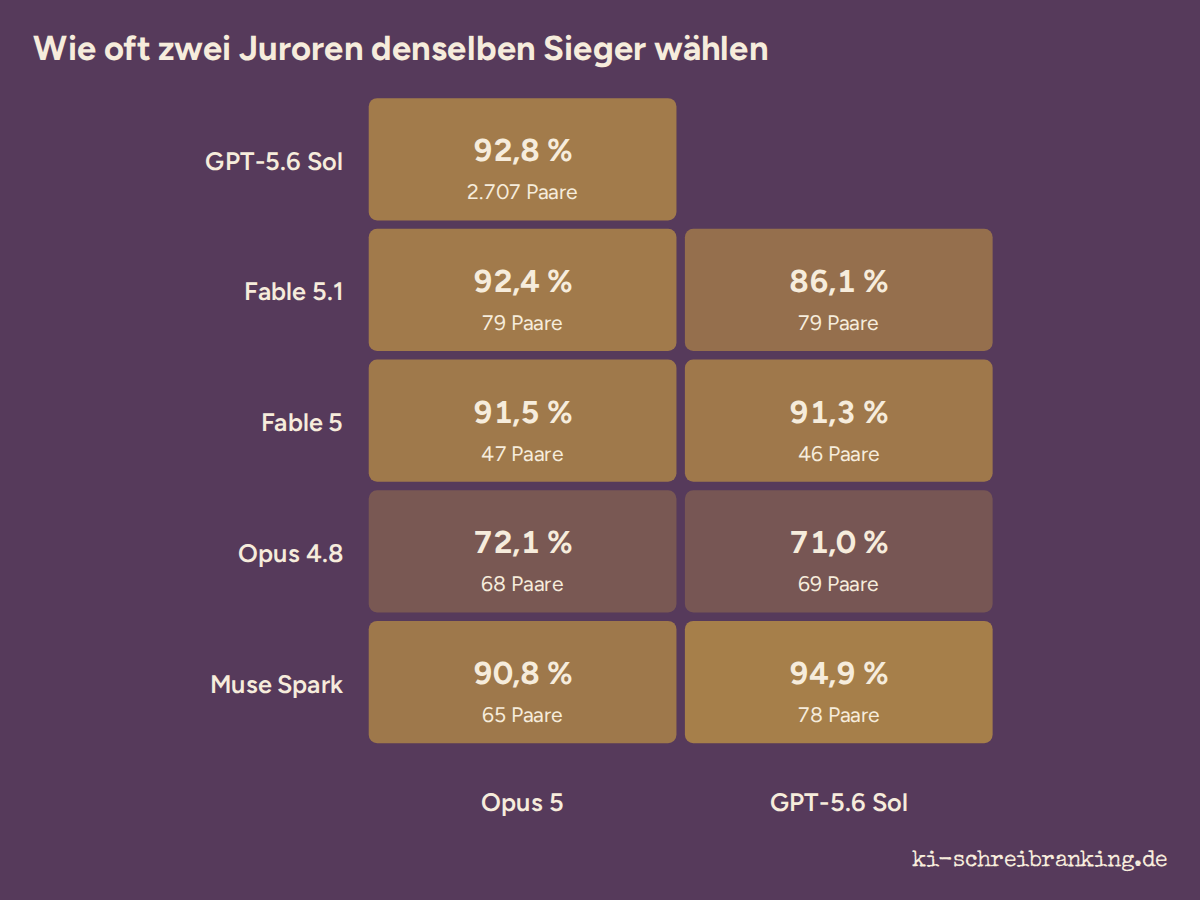 Die zwei großen KI-Juroren wählen in neun von zehn Fällen denselben Sieger. Der Streit liegt woanders
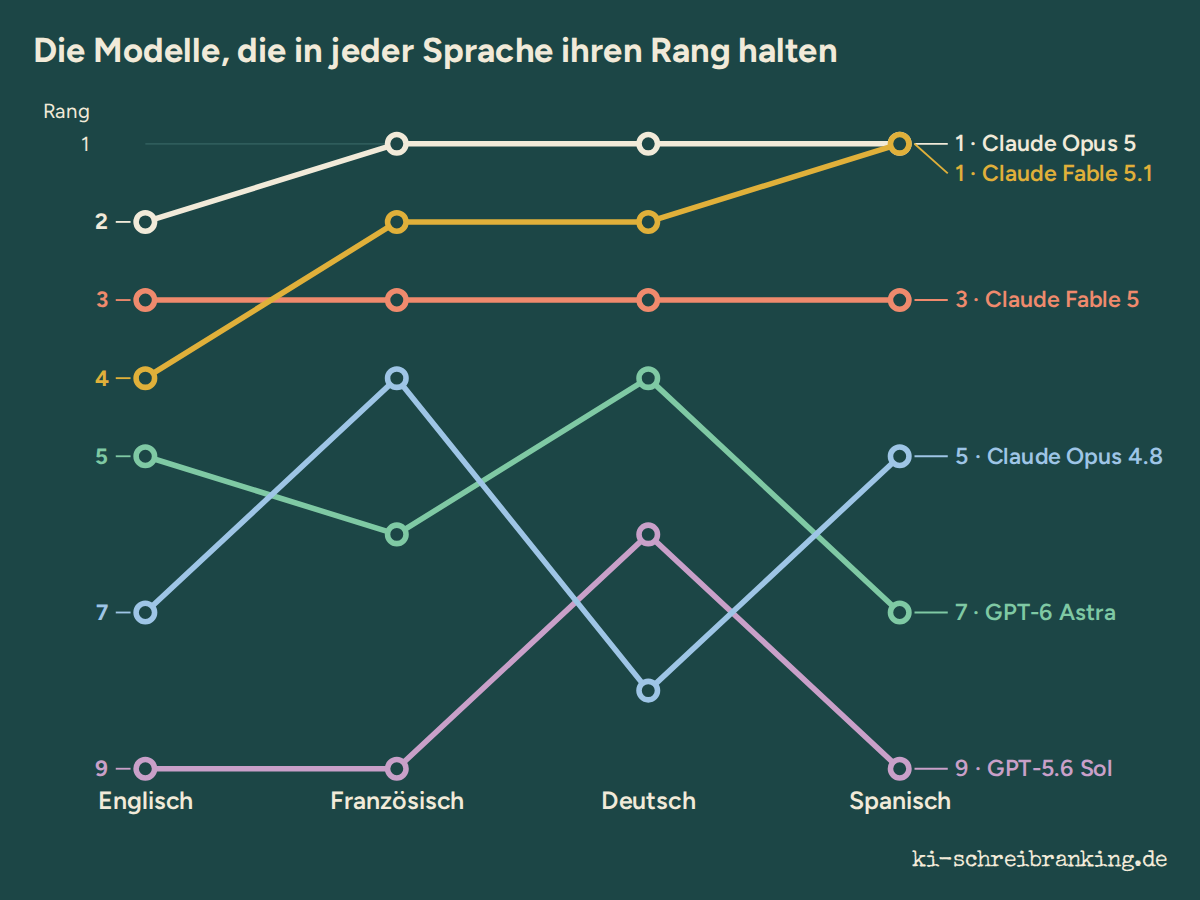 Ein Modell, vier Sprachen: Die ersten sechs bleiben, das Mittelfeld wandert um vierzig Plätze
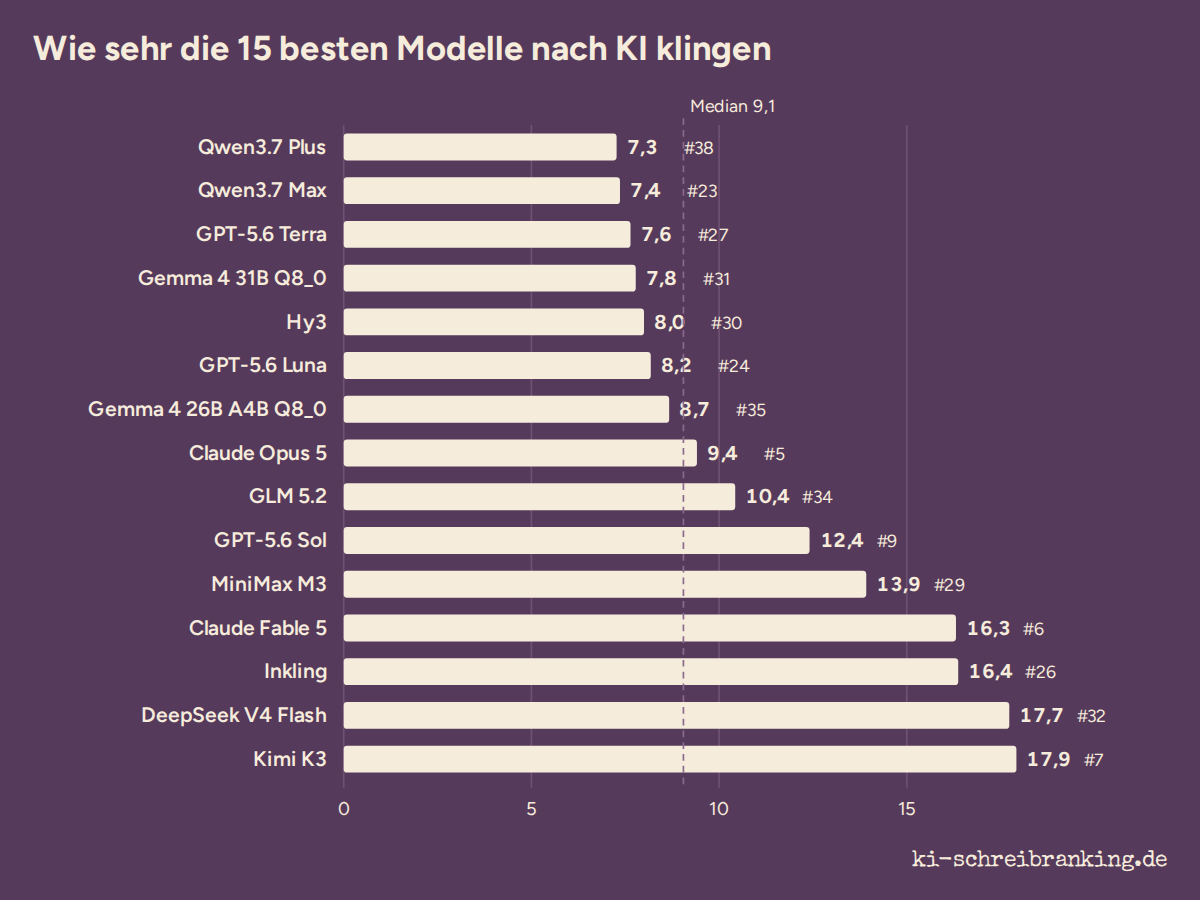 Welche KI klingt am wenigsten nach KI? Der Gedankenstrich verrät die besten Modelle
Claude gegen ChatGPT, Claude gegen Gemini, Gemma gegen Qwen: Die meistgesuchten Vergleiche haben jetzt eine eigene Seite mit dem Ergebnis der Blindduelle. Jedes gerankte Modell erhält außerdem einen Index typischer Maschinenprosa: Floskeln, Gedankenstriche, Dreierlisten.
Ling 3.0 Flash. Heute Platz 81 von 108, mit 21,8 Punkten. Beste seiner 2 gerankten Varianten: Ling 3.0 Flash von InclusionAI (Q4_K_M, ohne Reasoning).
50.000
Erreicht 58 Tage nach dem ersten Duell, 20 Tage nach der Marke von 25.000.

DeepSeek V4.1 Flash. Heute Platz 11 von 108, mit 89,6 Punkten. Das sind 20,0 Punkte mehr als beim Vorgänger DeepSeek V4 Flash (Platz 32, 69,6).
GPT-6 Astra. Heute Platz 3 von 108, mit 95,6 Punkten.
Claude Fable 5.1. Heute Platz 4 von 108, mit 95,5 Punkten. Das sind 0,8 Punkte mehr als beim Vorgänger Claude Fable 5 (Platz 6, 94,7).

Gemini 3.8 Flash. Heute Platz 12 von 108, mit 89,4 Punkten. Das sind 8,7 Punkte mehr als beim Vorgänger Gemini 3.6 Flash (Platz 22, 80,7).

Muse Spark 1.3. Heute Platz 17 von 108, mit 87,1 Punkten. Das sind 3,6 Punkte weniger als beim Vorgänger Muse Spark 1.2 (Platz 8, 90,7).
Inkling. Heute Platz 29 von 108, mit 74,8 Punkten.

Granite 4.2 8B. Heute Platz 107 von 108, mit 1,9 Punkten. Beste seiner 2 gerankten Varianten: Granite 4.2 8B von IBM (Q4_K_M, Reasoning full).

GLM 5.3 Flash. Heute Platz 63 von 108, mit 46,7 Punkten.
Granite 4.2 30B. Heute Platz 101 von 108, mit 7,4 Punkten. Beste seiner 3 gerankten Varianten: Granite 4.2 30B von IBM (Q6_K, Reasoning full).

Hy4 Preview. Heute Platz 21 von 108, mit 81,3 Punkten. Das sind 12,8 Punkte mehr als beim Vorgänger Hy3 (Platz 35, 68,5). Direkte Duelle gegen ihn gewonnen: 15 von 24 (63 %).

Qwen3.8 Flash. Heute Platz 59 von 108, mit 50,9 Punkten.
25.000
Erreicht 38 Tage nach dem ersten Duell.
75
Mit Muse Spark 1.2, 34 Tage nach dem ersten Duell.
Aion 3.0. Heute Platz 34 von 108, mit 68,7 Punkten.
Gemini 3.7 Flash. Heute Platz 16 von 108, mit 88,4 Punkten.
GLM 5.3. Heute Platz 18 von 108, mit 86,9 Punkten. Das sind 19,0 Punkte mehr als beim Vorgänger GLM 5.2 (Platz 36, 67,9). Direkte Duelle gegen ihn gewonnen: 15 von 24 (63 %).
Grok 4.6. Heute Platz 62 von 108, mit 47,7 Punkten.
Hy3. Heute Platz 35 von 108, mit 68,5 Punkten.
Mistral Medium 3.5. Heute Platz 69 von 108, mit 40,7 Punkten.
Muse Spark 1.2. Heute Platz 8 von 108, mit 90,7 Punkten.
Qwen3.8 Max. Heute Platz 20 von 108, mit 82,5 Punkten. Das sind 4,0 Punkte mehr als beim Vorgänger Qwen3.7 Max (Platz 25, 78,5).

Seed 2.1 Turbo. Heute Platz 74 von 108, mit 36,9 Punkten.
Qwen3.8 27B. Heute Platz 44 von 108, mit 60,8 Punkten. Beste seiner 6 gerankten Varianten: Qwen3.8 27B von Alibaba (Q8_0, Reasoning xhigh). Das sind 5,8 Punkte mehr als beim Vorgänger Qwen3.6 27B (Platz 53, 55,0).
50
Mit Gemma 4 12B, 28 Tage nach dem ersten Duell.
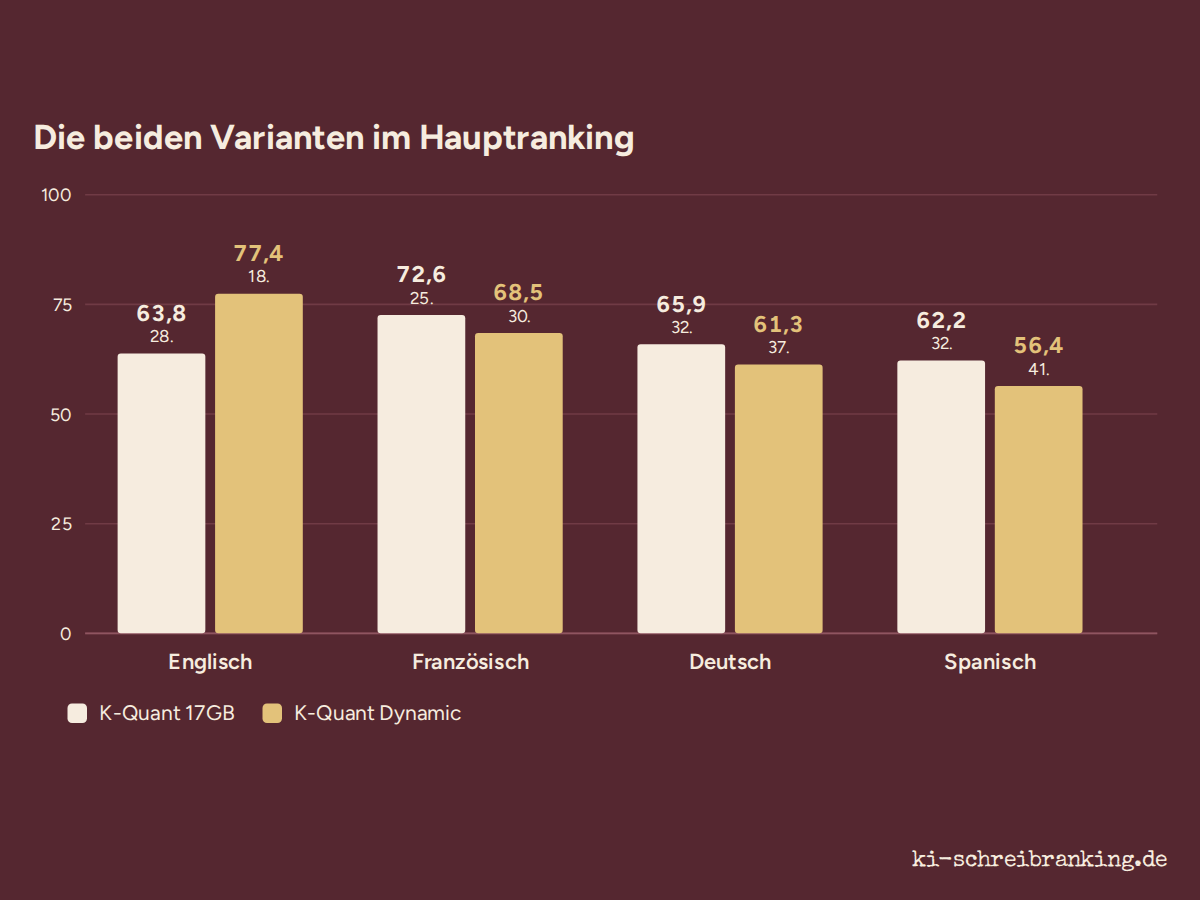
Muse Glimmer 30B. Heute Platz 41 von 108, mit 64,5 Punkten. Beste seiner 2 gerankten Varianten: Muse Glimmer 30B von Meta (K-Quant 17GB, Reasoning high).
Gemma 4 E2B. Heute Platz 89 von 108, mit 12,6 Punkten. Beste seiner 6 gerankten Varianten: Gemma 4 E2B von Google (Q6_K, ohne Reasoning).
Gemma 4 E4B. Heute Platz 84 von 108, mit 18,8 Punkten. Beste seiner 6 gerankten Varianten: Gemma 4 E4B von Google (Q8_0, Reasoning an).
Nemotron 3 Super 120B A12B. Heute Platz 76 von 108, mit 26,8 Punkten.

Laguna S 2.1 UD. Heute Platz 106 von 108, mit 2,1 Punkten.
Nemotron 3 Nano Omni 30B A3B. Heute Platz 98 von 108, mit 9,6 Punkten. Beste seiner 2 gerankten Varianten: Nemotron 3 Nano Omni 30B A3B von NVIDIA (Q4_K_M, Reasoning an).
Claude Sonnet 5. Heute Platz 24 von 108, mit 79,2 Punkten.
Gemini 3.6 Flash. Heute Platz 22 von 108, mit 80,7 Punkten.
Claude Opus 5. Heute Platz 5 von 108, mit 95,1 Punkten. Das sind 6,0 Punkte mehr als beim Vorgänger Claude Opus 4.8 (Platz 13, 89,1).
GPT-5.6 Luna. Heute Platz 27 von 108, mit 77,8 Punkten.
Kimi K3. Heute Platz 7 von 108, mit 93,3 Punkten.
Claude Fable 5. Heute Platz 6 von 108, mit 94,7 Punkten.
GPT-5.6 Sol. Heute Platz 10 von 108, mit 90,2 Punkten.
25
Mit Claude Opus 4.8, 6 Tage nach dem ersten Duell.
Claude Opus 4.8. Heute Platz 13 von 108, mit 89,1 Punkten.
GPT-5.6 Terra. Heute Platz 28 von 108, mit 77,7 Punkten.
Gemma 4 12B. Heute Platz 49 von 108, mit 59,2 Punkten. Beste seiner 6 gerankten Varianten: Gemma 4 12B von Google (Q8_0, ohne Reasoning).
MiniMax M3. Heute Platz 31 von 108, mit 70,8 Punkten.
Gemma 4 26B A4B. Heute Platz 37 von 108, mit 66,8 Punkten. Beste seiner 6 gerankten Varianten: Gemma 4 26B A4B von Google (Q8_0, Reasoning an).
Qwen3.6 35B A3B. Heute Platz 69 von 108, mit 40,7 Punkten. Beste seiner 4 gerankten Varianten: Qwen3.6 35B A3B von Alibaba (Q8_0, Reasoning an).
DeepSeek V4 Flash. Heute Platz 32 von 108, mit 69,6 Punkten. Beste seiner 2 gerankten Varianten: DeepSeek V4 Flash von DeepSeek (Reasoning an).
Gemma 4 31B. Heute Platz 33 von 108, mit 68,9 Punkten. Beste seiner 6 gerankten Varianten: Gemma 4 31B von Google (Q8_0, Reasoning an).
GLM 5.2. Heute Platz 36 von 108, mit 67,9 Punkten.
MiMo V2.5 Pro. Heute Platz 46 von 108, mit 60,0 Punkten. Beste seiner 2 gerankten Varianten: MiMo V2.5 Pro von Xiaomi (Reasoning an).
Mistral Medium 3.5 128B. Heute Platz 64 von 108, mit 46,3 Punkten.
Qwen3.6 27B. Heute Platz 53 von 108, mit 55,0 Punkten. Beste seiner 3 gerankten Varianten: Qwen3.6 27B von Alibaba (Q8_0, Reasoning an).
Qwen3.7 Max. Heute Platz 25 von 108, mit 78,5 Punkten. Beste seiner 2 gerankten Varianten: Qwen3.7 Max von Alibaba (Reasoning an).
Alle Modelle nach ihrer Schreibqualität auf Deutsch, mit Filtern nach Textsorte, Anbieter, Größe, Reasoning und Quantisierung, dazu die Duellmatrizen.
Die laufend aktualisierte Rangliste offener Modelle für deutsche Texte, der Speicherbedarf jeder Datei und was in 16, 24, 32 oder 128 GB passt.
Datengestützte Artikel zu den Juroren, zur Quantisierung, zum Reasoning und zu den vier Sprachen.