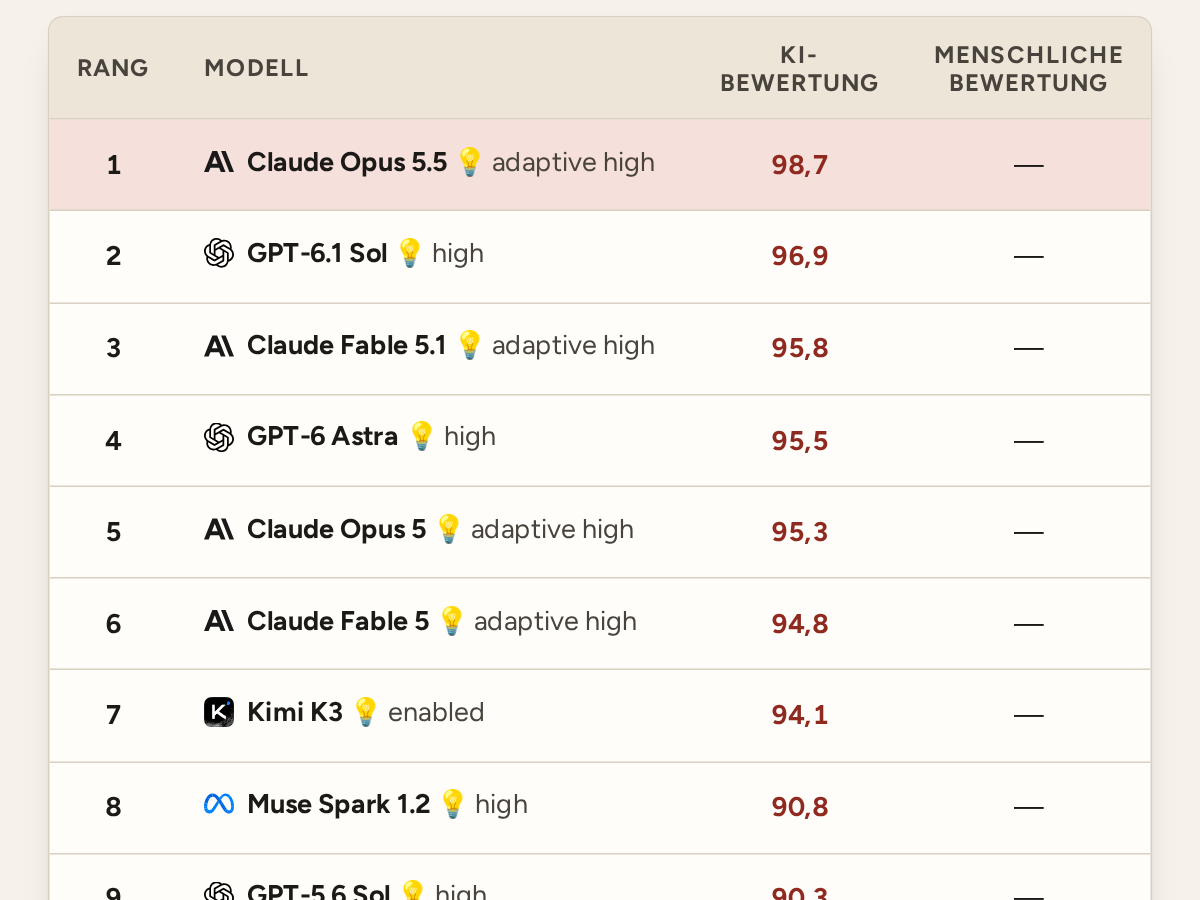
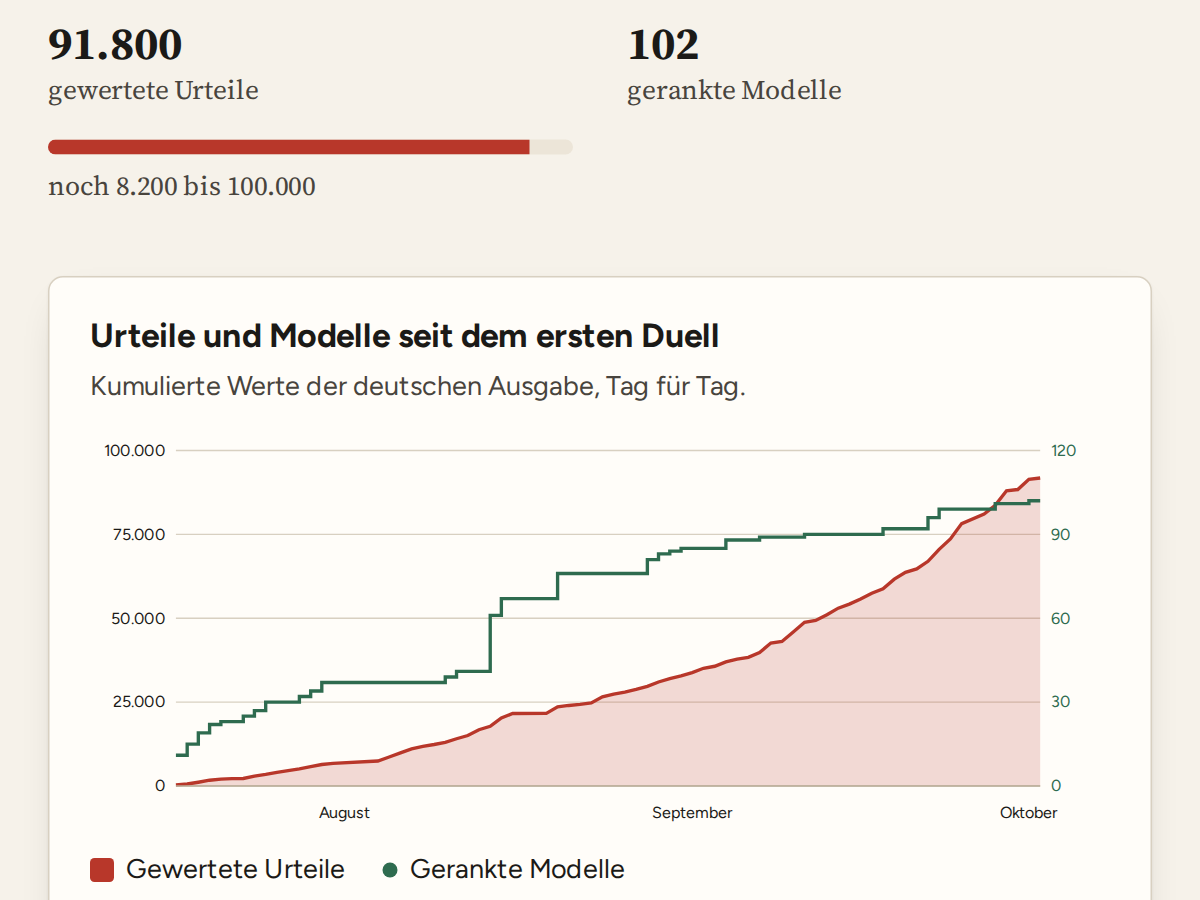
Ich heiße Johannes Eva und entwickle seit 27 Jahren Websites. Das KI-Schreibranking entstand aus einer Lücke: Keine bestehende Rangliste maß, was mich interessierte, nämlich die Schreibqualität von KI-Modellen auf Deutsch.
Öffentliche Benchmarks konzentrieren sich vor allem auf Code, Mathematik und logisches Denken. Der kleine Teil, der sich mit Schreiben beschäftigt, wird fast immer auf Englisch bewertet. Hier zählt nur die Qualität der erzeugten Texte. Die Aufgaben werden direkt auf Deutsch entwickelt, die Antworten blind verglichen.
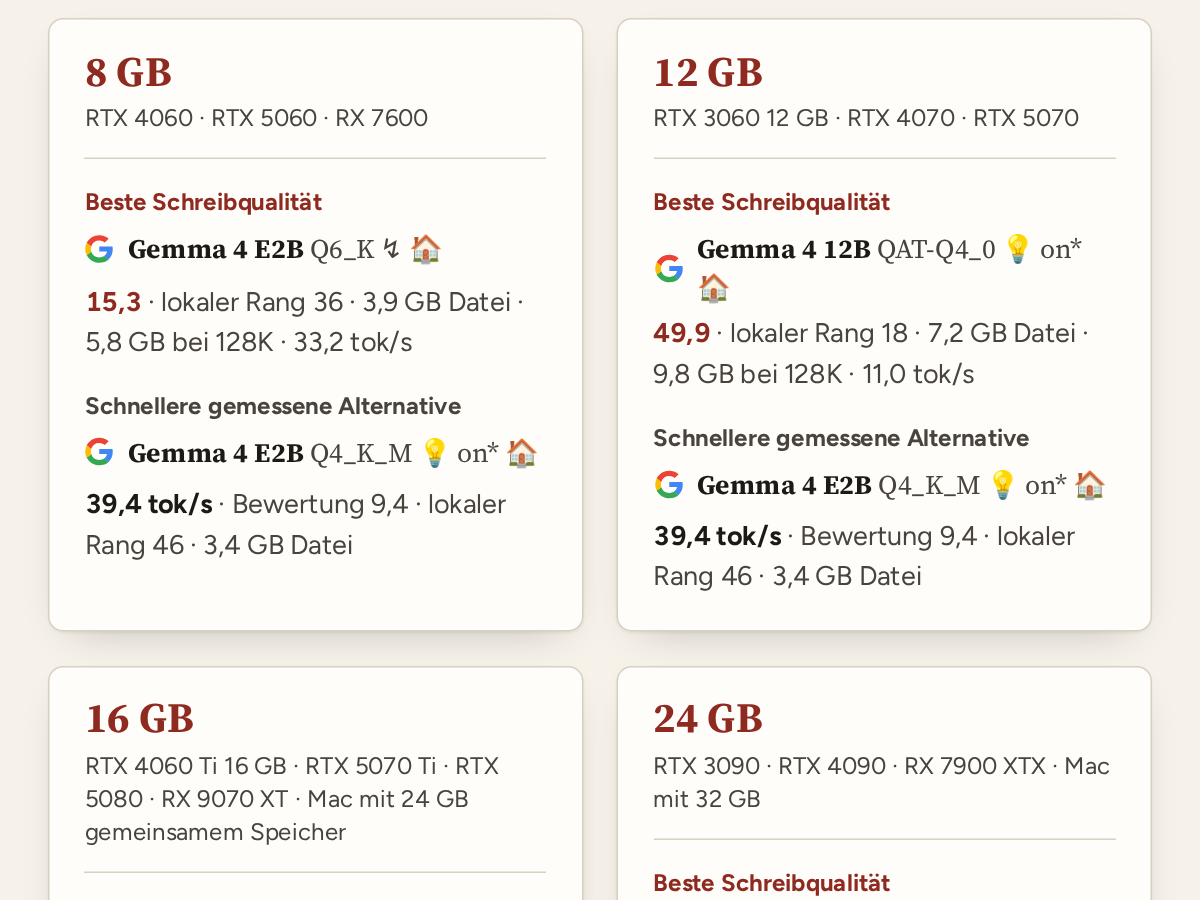
Modelle, die auf dem eigenen Rechner laufen, haben einen besonderen Platz. Gemma 4, Qwen 3.6 und 3.8, Ling 3.0 Flash, Muse Glimmer und Granite 4.2 gehören zu den Familien, die mit 🏠 gekennzeichnet sind. Sie wurden lokal in mehreren Quantisierungen ausgeführt, mit aktiviertem und deaktiviertem Reasoning. Seit dem 22. September 2026 erzeugen wir keine neuen lokalen Antworten mehr; die vorhandenen werden weiterhin beurteilt.
Diese Website ist ein persönliches Projekt. Kein Modellentwickler bezahlt mich, und ich habe keinen Grund, ein Modell zu bevorzugen.
Die Rechner für die lokalen Modelle
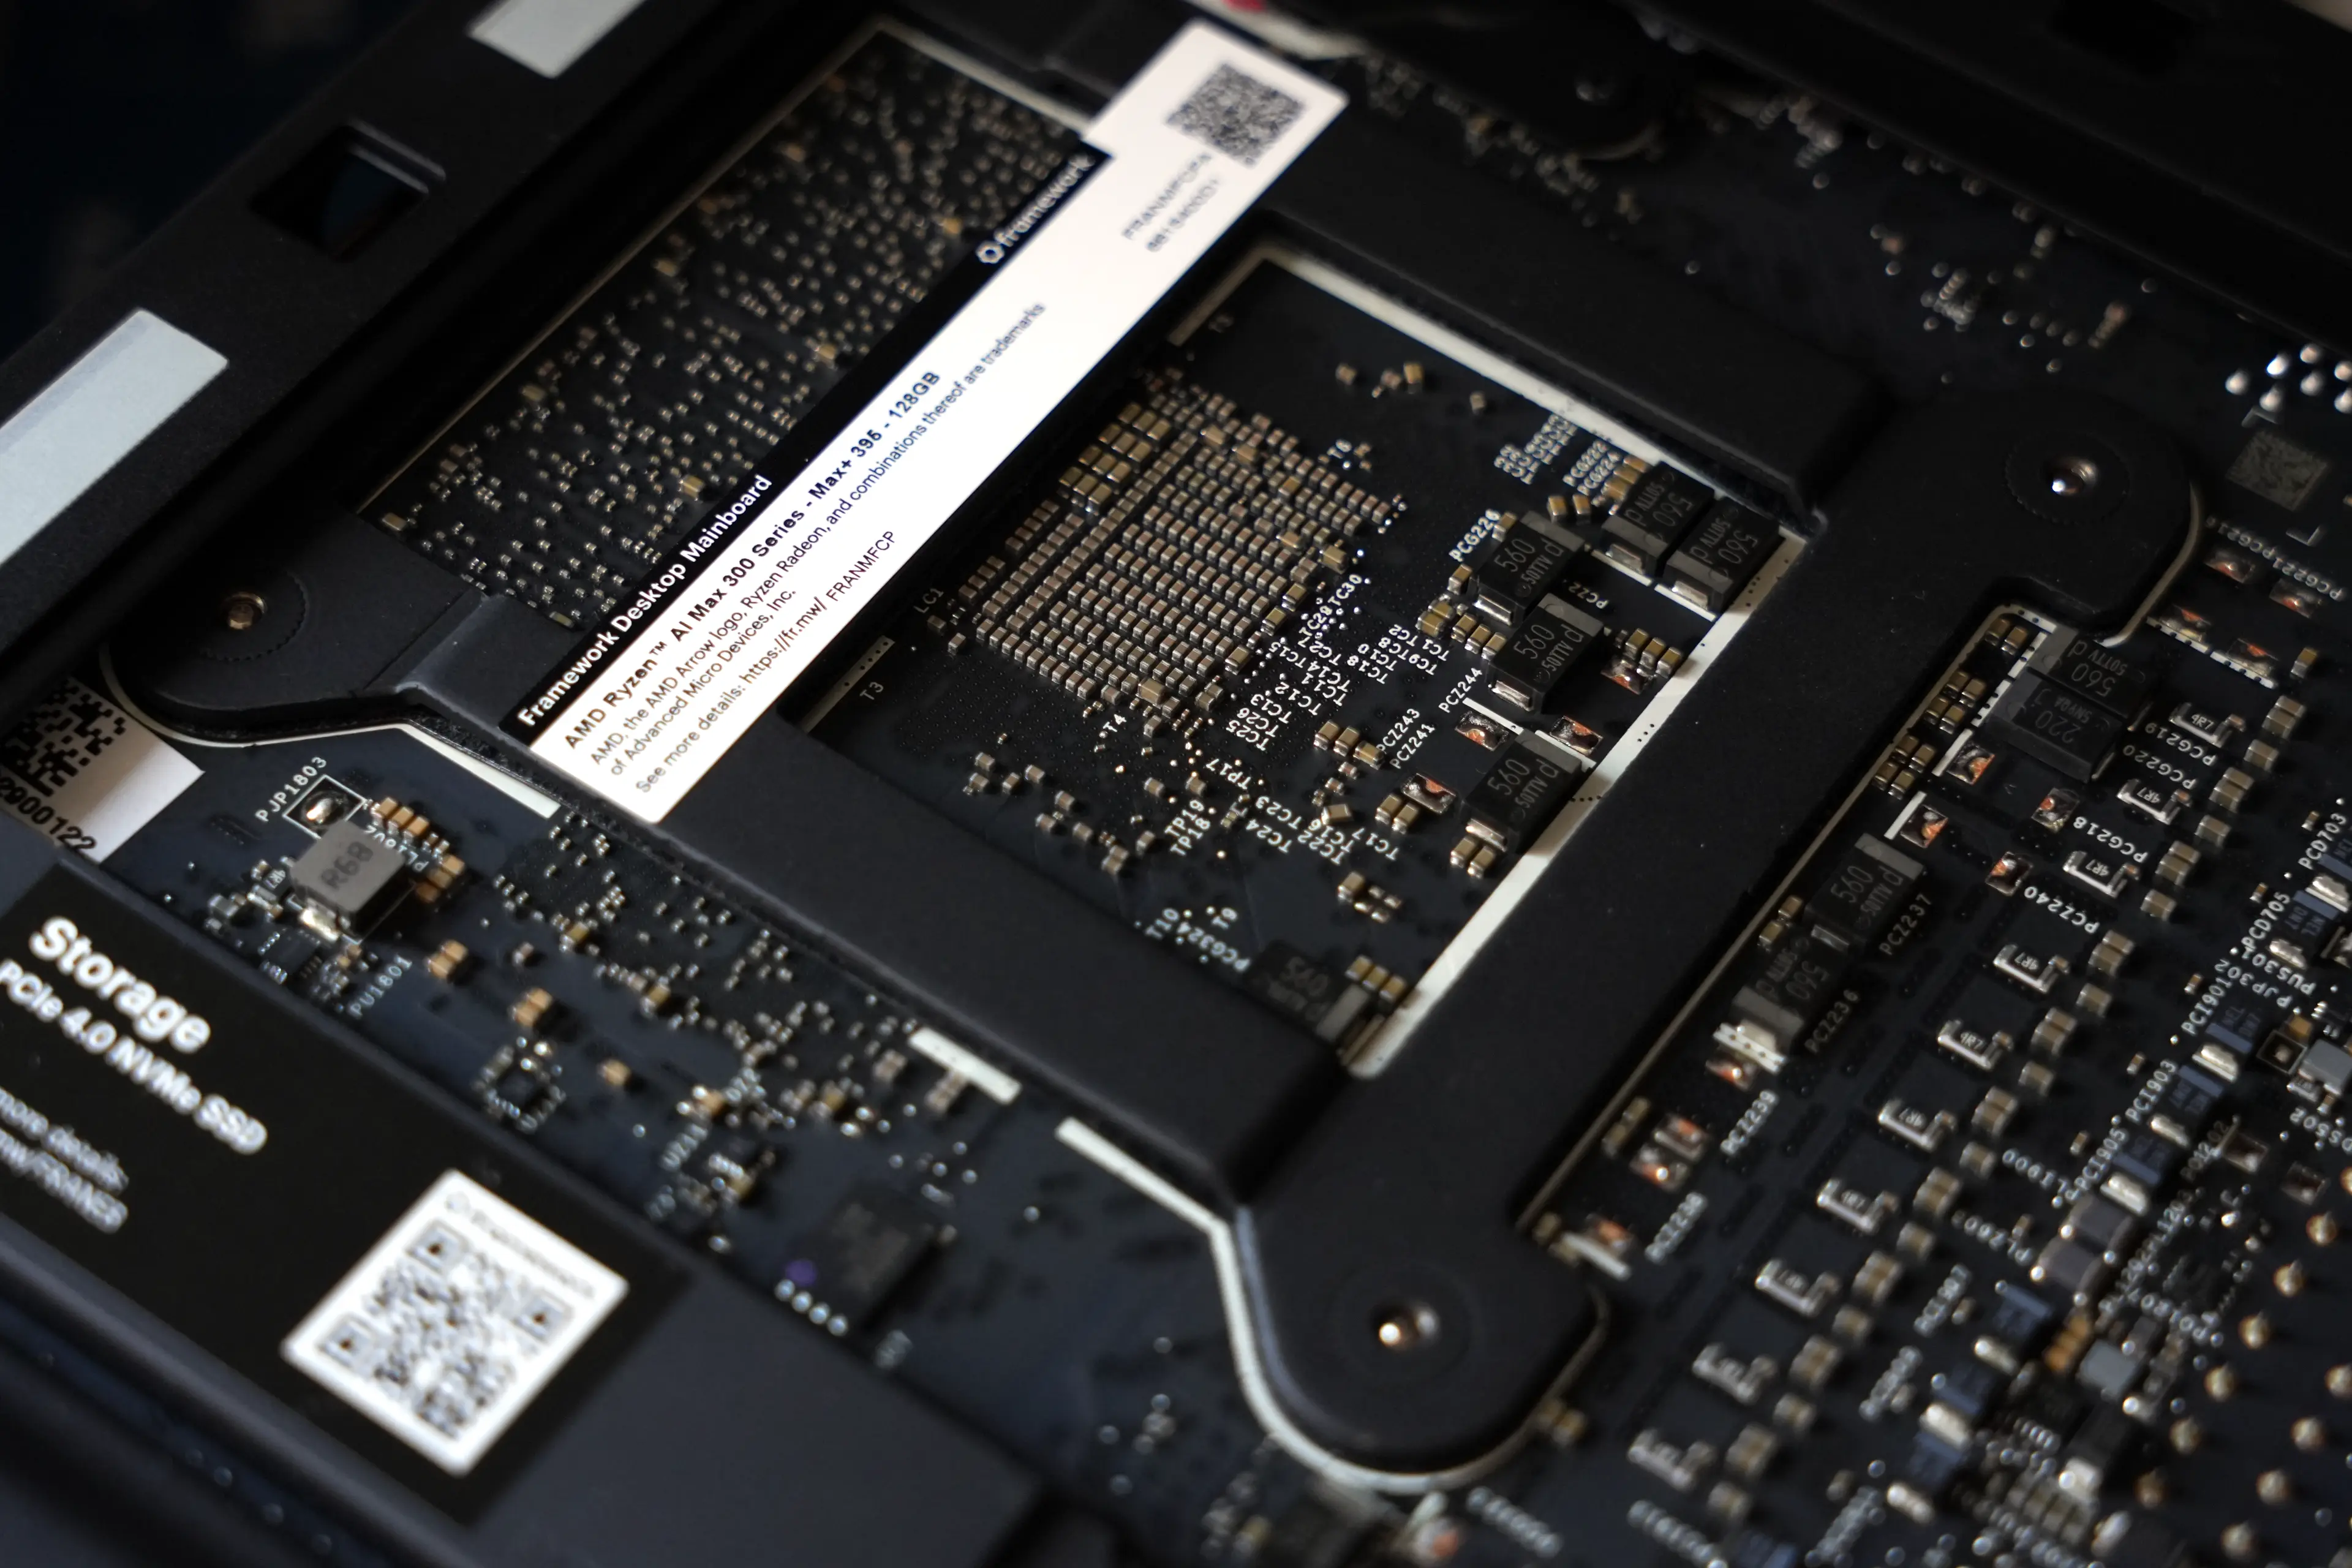
- Rechner
- Framework Desktop, Serie AMD Ryzen AI Max 300, Revision A6
- Prozessor
- AMD Ryzen AI Max+ 395, 16 Kerne und 32 Threads, bis zu 5,19 GHz
- Grafik
- Integrierte AMD Radeon 8060S
- Speicher
- 128 GB gemeinsamer Speicher für Prozessor und Grafikeinheit
Die lokalen Modelle wurden bis zum 22. September 2026 auf einem Framework Desktop mit AMD Ryzen AI Max+ 395 ausgeführt, mit LM Studio. Seine 128 GB gemeinsamer Speicher (Unified Memory) stehen Prozessor und Grafikeinheit zur Verfügung. So lassen sich größere Modelle laden, als es mit den meisten Grafikkarten für Privatanwender möglich wäre. Ein zweiter Rechner mit einer NVIDIA GeForce RTX 5070 Ti steuerte einige leichtere Modelle bei.
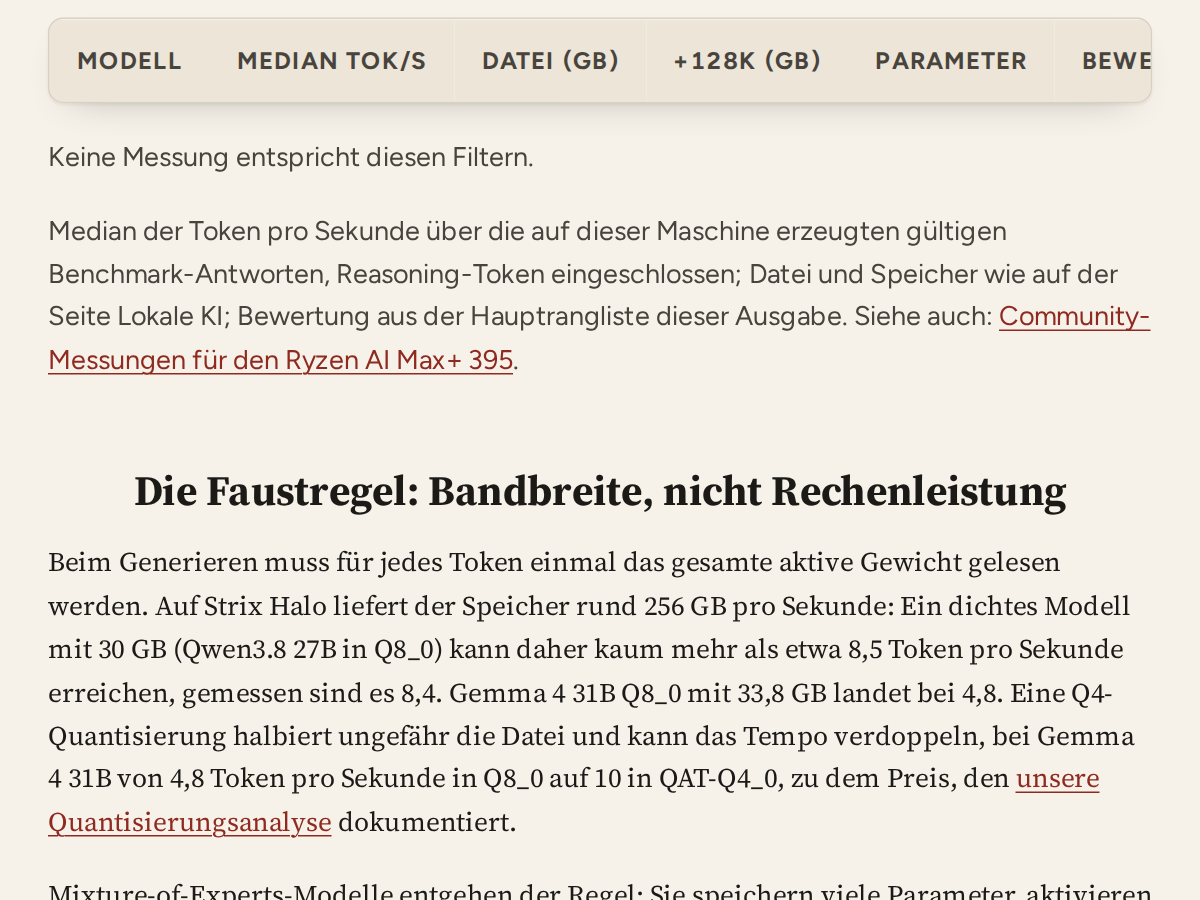
Die auf diesem Rechner gemessenen Generierungsgeschwindigkeiten, Modell für Modell und Quantisierung für Quantisierung, stehen auf der Seite Strix-Halo-Tempo.