

Welche lokale KI schreibt am besten?
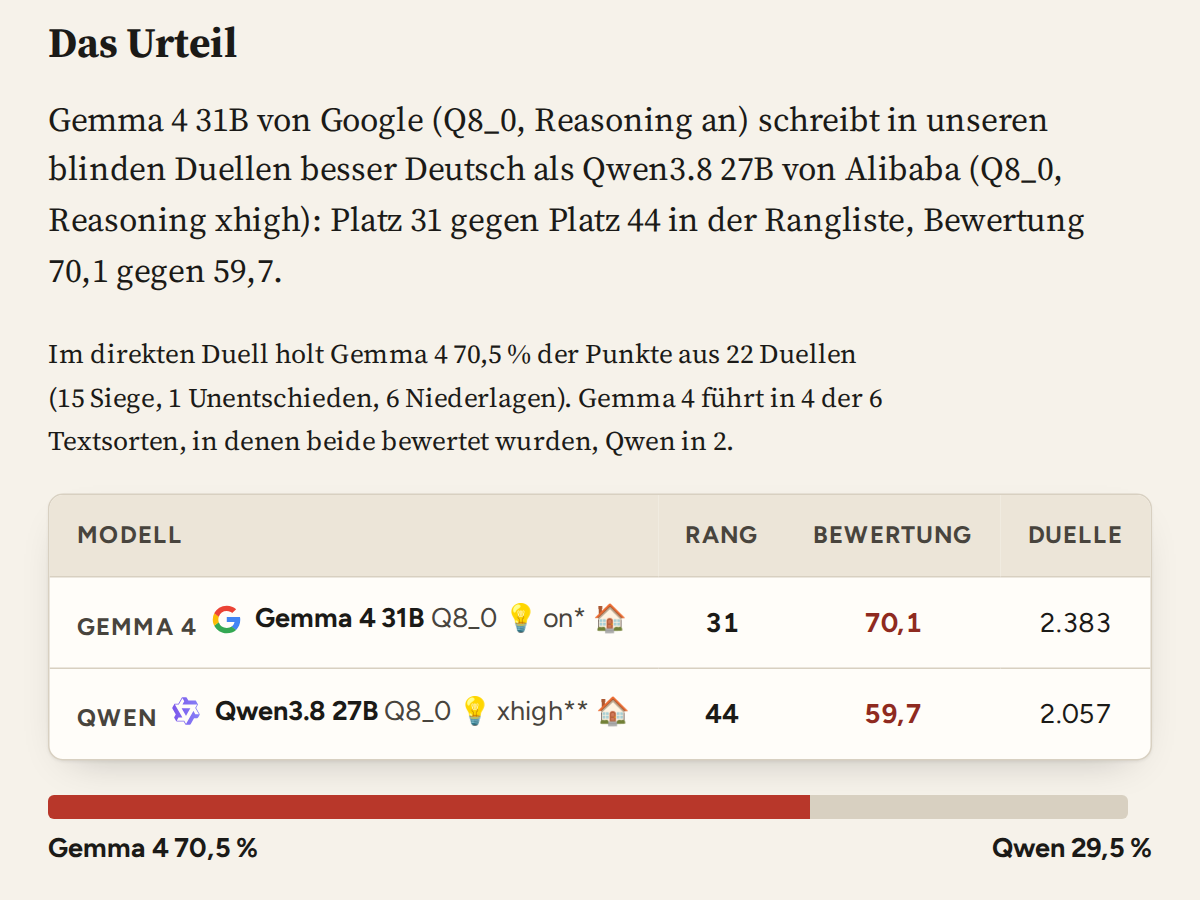
Gemma 4 31B von Google (Q8_0, Reasoning an) ist die beste lokale Variante der aktuellen Auswahl, mit einer Bewertung von 67,6. Sie braucht 45,8 GB bei einem Kontext von 128K.
Was hier als lokal gilt
Vier Bedingungen, streng angewendet:
- Offene Gewichte. Die Modelldateien sind öffentlich herunterladbar und lassen sich außerhalb der Infrastruktur des Anbieters ausführen.
- Wirklich offline lauffähig. Keine zugangsbeschränkte Schnittstelle mit offen klingendem Namen.
- Weniger als 256 Mrd. Parameter insgesamt. Strikt unterhalb dieser Grenze.
- Bereits auf dieser Website bewertet. Keine Schätzungen und keine Platzhalter in der Rangliste selbst.
Die Grenze gilt für die Gesamtzahl der Parameter, auch bei Mixture-of-Experts-Modellen. Das ist ein häufiger und folgenreicher Irrtum: Ein MoE-Modell, das je Token nur einen kleinen Teil seiner Parameter aktiviert, muss trotzdem alle Gewichte im Speicher halten. Die Gesamtzahl entscheidet über Zulassung und Speicherbedarf, die aktiven Parameter über das Tempo. Sind beide bekannt, nennt der Modellname beide (zum Beispiel 35B A3B), damit die aktive Zahl als Hinweis auf die Geschwindigkeit dient und nicht mit dem Speicherbedarf verwechselt wird.
Nicht verlangt wird, dass die Antworten eines Modells auf einem Rechner dieses Projekts entstanden sind. Zulässig ist ein Modell, weil seine Gewichte verfügbar sind und es sich lokal ausführen lässt. Die meisten lokalen Varianten dieser Rangliste wurden bis zum 22. September 2026 auf unseren eigenen Rechnern erzeugt; seitdem entstehen keine neuen lokalen Antworten mehr, die vorhandenen werden aber weiter beurteilt. Wo wir den Durchsatz einer Variante selbst gemessen haben, ist die Geschwindigkeit als eigene Messung gekennzeichnet.
Was ein LLM ist, und was „lokal“ daran ändert
LLM steht für Large Language Model, ein großes Sprachmodell. Vereinfacht gesagt ist das eine sehr umfangreiche Datei aus Zahlen – den sogenannten Gewichten – plus ein Programm, das diese Datei benutzt, um zu einem Text jeweils die nächste plausible Fortsetzung zu berechnen. Aus dieser Mechanik entstehen Antworten, Aufsätze, Übersetzungen, Dialoge.
Bei Cloud-Diensten liegt diese Datei auf fremden Servern. Bei lokalen LLMs laden Sie sie herunter und führen sie selbst aus. Wenn auch Laufzeit und Integrationen lokal bleiben, müssen Ihre Texte den Rechner nicht verlassen. Das Modell funktioniert ohne Internetverbindung, es ändert sich nicht über Nacht durch ein Update des Anbieters, und Sie behalten die Kontrolle über Systemprompt, Kontextlänge und Einstellungen. Für Manuskripte, Mandantenunterlagen, unveröffentlichte Recherchen oder personenbezogene Daten ist das oft der entscheidende Punkt.
Datenschutz ist allerdings ein Argument für lokale Ausführung, kein Argument für die Schreibqualität eines bestimmten Modells. Beides bewerten wir getrennt.
Offene Gewichte sind nicht dasselbe wie Open Source
Für dieses Ranking zählt ein technisches Kriterium: offene Gewichte (open-weight). Die Modelldatei ist herunterladbar und lokal ausführbar. Ob die Lizenz im Sinne der Open-Source-Definition frei ist, ob Trainingsdaten und Trainingscode offenliegen, ist eine andere – und für Unternehmen durchaus relevante – Frage. Viele populäre Modelle sind open-weight, aber nicht Open Source; manche Lizenzen schränken kommerzielle Nutzung ein. Prüfen Sie die Lizenz für Ihren Anwendungsfall selbst. Sie sagt nichts über die Qualität der deutschen Texte aus, und wir behandeln sie hier auch nicht als Qualitätsmerkmal.
Quantisierung: was sie ist, was sie bringt, was sie kostet
Die Gewichte eines Modells sind ursprünglich in relativ hoher Zahlenpräzision gespeichert, üblicherweise 16 Bit pro Wert. Quantisierung speichert dieselben Gewichte mit weniger Bit. Die Datei schrumpft, der Speicherbedarf sinkt – und weil Inferenz auf üblicher Hardware häufig durch die Speicherbandbreite begrenzt ist, nicht durch Rechenleistung, kann eine kleinere Variante zusätzlich schneller antworten.
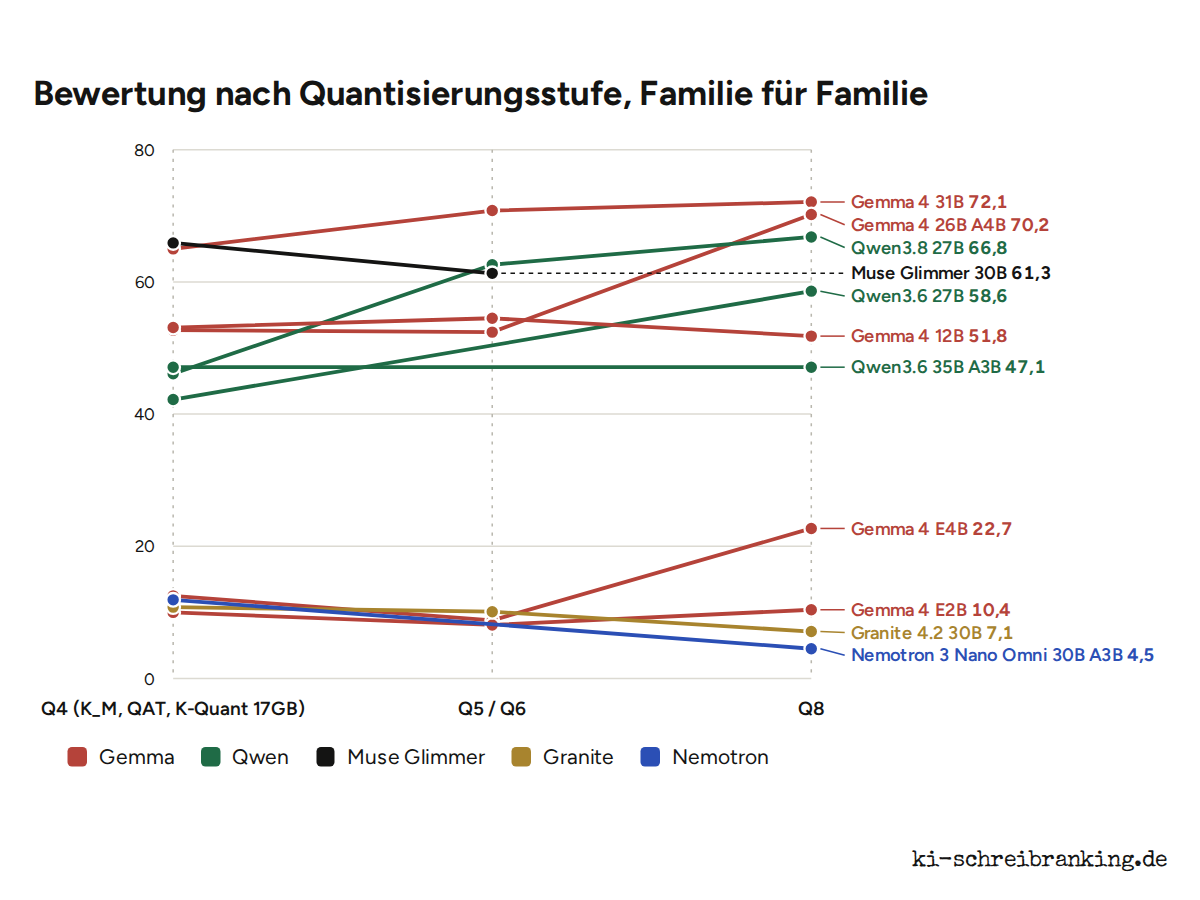
Der Preis ist ein möglicher Qualitätsverlust. Wie groß er ausfällt, hängt vom Modell ab, vom Quantisierungsverfahren, von der Aufgabe, von der Sprache, von der Kontextlänge und von der Stufe. Es gibt keinen allgemeingültigen Prozentwert „erhaltener Qualität“, und Aussagen dieser Form sollten Sie grundsätzlich misstrauisch machen.
Die Stufen, die in unserem Filter vorkommen:
- Q8 – eine Acht-Bit-Variante. Wir behandeln sie als praktische Qualitätsreferenz für lokale Ausführung, weil sie in der Regel die geringsten Abweichungen zeigt. Ob sie im Einzelfall von einer BF16/FP16-Version unterscheidbar ist, ist eine empirische Frage und keine Selbstverständlichkeit.
- Q4 QAT – Quantization-Aware Training. Das Modell wurde bereits im Hinblick auf Vier-Bit-Ausführung trainiert oder nachbearbeitet. Das ist ein eigener Checkpoint, keine nachträgliche Umwandlung, und deshalb im Ranking eine eigene Zeile.
- Q6 – ein Zwischenschritt zwischen Q4 und Q8. Mehrere Familien liegen in bewerteten Q6_K-Varianten vor; sie werden standardmäßig angezeigt.
- Q4 (Q4_K_M) – eine nachträgliche Vier-Bit-Quantisierung im GGUF-Format mit gemischter Präzision für unterschiedliche Gewichtsgruppen. Das ist ausdrücklich kein QAT, auch wenn beide „Q4“ im Namen tragen. Die beiden Wege zu vier Bit sind nicht austauschbar.
- ≈ Q4 (K-Quant) und ≈ Q5 (K-Quant Dynamic) – die beiden eigenen Dateien von Muse Glimmer 30B, im nächsten Abschnitt erklärt. Das „≈“ steht dafür, dass sie keinem Standardformat entsprechen, sondern nur in dieselbe Größenordnung fallen.
Die Filter wirken sofort, und ihr Zustand steht in der Adresse der Seite: Eine gefilterte Ansicht lässt sich verlinken oder als Lesezeichen speichern.
Die beiden K-Quant-Varianten von Muse Glimmer
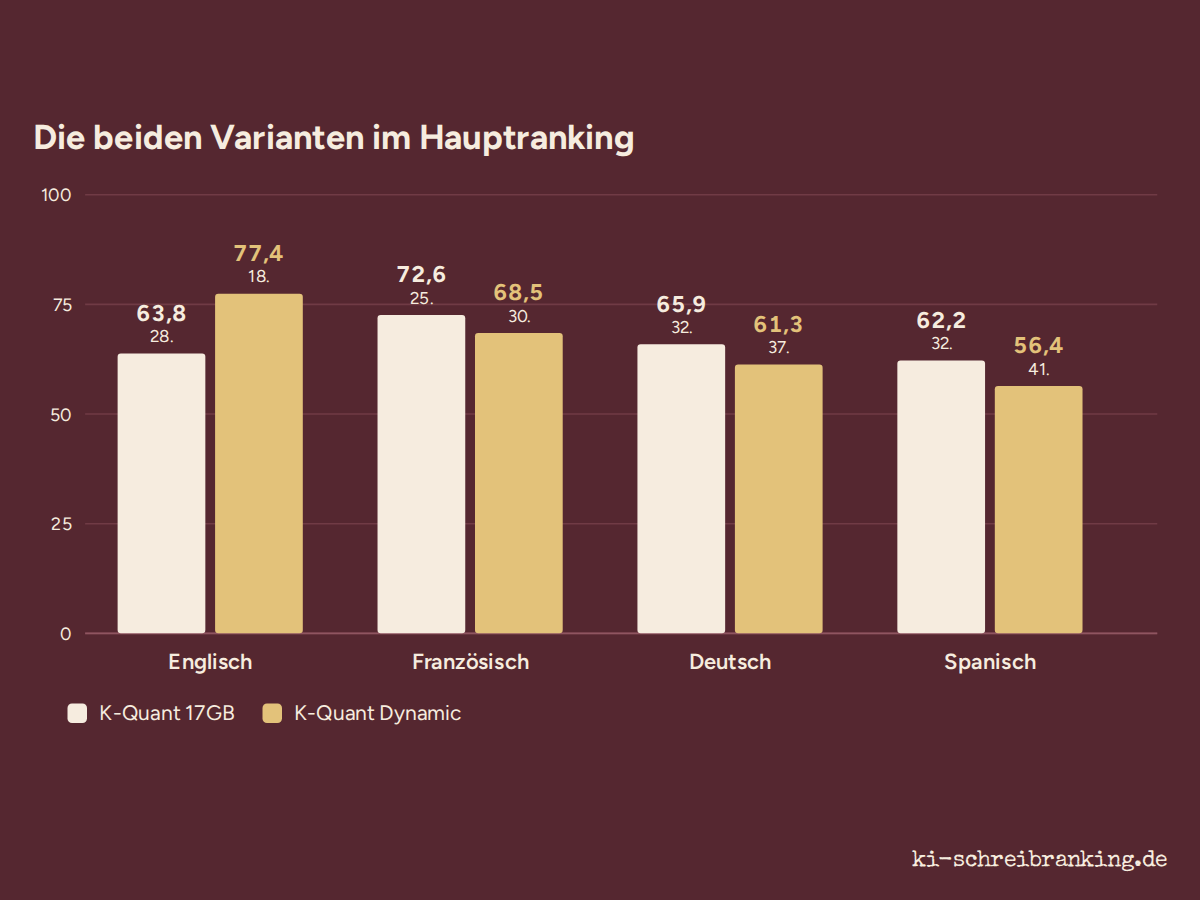
Meta veröffentlicht Muse Glimmer 30B in zwei ungewöhnlichen GGUF-Dateien mit durchschnittlich vier bis fünf Bit pro Gewicht. K-Quant Dynamic bewahrt ausgewählte Tensoren in höherer Präzision und zielt auf 32 GB VRAM; K-Quant 17GB komprimiert stärker und zielt auf 24 GB. Es sind keine Q4_K_M-Dateien. Deshalb behalten wir die exakten Namen bei und bewerten beide als getrennte Varianten. Im Filter stehen sie unter eigenen Einträgen: K-Quant 17GB unter „≈ Q4 (K-Quant)“, K-Quant Dynamic unter „≈ Q5 (K-Quant Dynamic)“, weil diese Datei im Mittel mehr Bit pro Gewicht behält.
Meta nennt über fünfzehn verbreitete Benchmarks eine durchschnittliche Verschlechterung von 0,2 % beziehungsweise 1,0 %. Das sind Messungen des Herausgebers, keine Schreibwerte dieses Rankings und keine Garantie für deutsche, englische, französische oder spanische Prosa. Unser Ranking und der direkte Vergleich messen beide Dateien getrennt an nativ verfassten Schreibaufgaben.
Welche Hardware für welches Modell?
Die häufigste Frage lautet nicht „welches Modell schreibt am besten“, sondern „welches Modell schreibt am besten auf meinem Rechner“. Diese Leiter beantwortet sie für die üblichen Speichergrößen, von der 8-GB-Grafikkarte bis zur Workstation mit 128 GB gemeinsamem Speicher. Jede Stufe nennt die am besten schreibende Variante, die hineinpasst, und die schnellste von uns gemessene Variante, die ebenfalls passt. Stufen, auf denen sich nichts ändert, sind zusammengefasst.
8 GB
RTX 4060 · RTX 5060 · RX 7600
Beste Schreibqualität
 Gemma 4 E2B ↯ 🏠
Schnellere gemessene Alternative
Gemma 4 E2B 💡 🏠
12 GB
RTX 3060 12 GB · RTX 4070 · RTX 5070
Beste Schreibqualität
Gemma 4 12B 💡 🏠
Schnellere gemessene Alternative
Gemma 4 E2B 💡 🏠
16 GB
RTX 4060 Ti 16 GB · RTX 5070 Ti · RTX 5080 · RX 9070 XT · Mac mit 24 GB gemeinsamem Speicher
Beste Schreibqualität
Gemma 4 12B ↯ 🏠
Schnellere gemessene Alternative
Gemma 4 E2B 💡 🏠
24 GB
RTX 3090 · RTX 4090 · RX 7900 XTX · Mac mit 32 GB
Beste Schreibqualität
 Muse Glimmer 30B 💡 🏠
Schnellere gemessene Alternative
Gemma 4 E2B 💡 🏠
32 GB
RTX 5090 · Mac mit 48 GB
Beste Schreibqualität
Gemma 4 26B A4B 💡 🏠
Schnellere gemessene Alternative
Gemma 4 26B A4B ↯ 🏠
48–128 GB
48 GB: RTX 6000 Ada · zwei 24-GB-Karten · Mac mit 64 GB · Strix Halo 64 GB64 GB: Mac mit 96 GB96 GB: RTX PRO 6000 · Mac mit 128 GB · DGX Spark · Strix Halo 128 GB (96 GB zugewiesen)128 GB: Mac Studio mit 192 GB oder mehr
Beste Schreibqualität
Gemma 4 31B 💡 🏠
Schnellere gemessene Alternative
Gemma 4 26B A4B 💡 🏠
Richtwerte für das Laden, keine Garantien: Kontext, KV-Cache, Batch und Laufzeitumgebung verändern den Bedarf. Die Geschwindigkeiten stammen von unserem Strix-Halo-Rechner, beschrieben auf der Seite Strix-Halo-Tempo, und lassen keine Vorhersage für andere Plattformen zu.
Wie „passt“ entschieden wird
Eine Variante kommt in eine Stufe, wenn ihr geschätzter Speicherbedarf höchstens so groß ist wie die Stufe. Die Schätzung nimmt die GGUF-Datei, plus 8 % für die Puffer der Laufzeitumgebung, plus 2 GB für einen kurzen Kontext, aufgerundet auf die nächste übliche Kartengröße. Das ist vorsichtig für kurze Prompts und optimistisch für lange Dokumente: Die Angabe „bei 128K“ auf jeder Karte zeigt, was dieselbe Variante mit 128.000 Token Kontext braucht, KV-Cache eingeschlossen, und bei manchen Modellen verdoppelt sich damit das Budget. Wer mit langen Texten arbeitet, sollte diese Zahl lesen, nicht die Dateigröße. Die Werte folgen den Standardeinstellungen von LM Studio, in dezimalen Gigabyte wie LM Studio: die getestete GGUF-Datei, Bild-Encoder eingeschlossen, wo das Modell einen hat, plus der F16-Cache der Schichten mit voller Aufmerksamkeit (Schichten mit gleitendem Fenster und rekurrente Schichten wachsen kaum, deshalb brauchen Gemma 4 und Qwen 3.x weit weniger, als eine naive Rechnung ergibt), mit aktiver Flash Attention. 128K steht für 131.072 Token, die Einstellung, die LM Studio anbietet. Die Rangliste zeigt außerdem den Bedarf bei 256K und lässt sich auf einen Q8-Cache (fast halb so groß wie F16) und auf die MLX-Dateien für den Mac umschalten.
Dedizierte Grafikkarte oder gemeinsamer Speicher
Eine Grafikkarte liefert die Speicherbandbreite, die die Generierung schnell macht, aber ihre Größe ist fest: 8, 12, 16, 24 oder 32 GB bei Karten für Privatanwender. Rechner mit gemeinsamem Speicher (Unified Memory: Macs mit Apple Silicon, AMD Strix Halo, Nvidia DGX Spark) teilen sich einen Speicherpool zwischen Prozessor und Grafik. Sie fassen Modelle, die auf keine solche Karte passen, aber der Pool ist langsamer und steht dem Modell nicht vollständig zur Verfügung. Rechnen Sie mit etwa drei Vierteln des gemeinsamen Speichers als nutzbar: Deshalb steht ein Mac mit 24 GB in der 16-GB-Stufe, ein Strix Halo mit 64 GB in der 48-GB-Stufe und ein Strix Halo mit 128 GB (96 GB der Grafik zugewiesen) in der 96-GB-Stufe. Die Beispiele unter jeder Stufe wenden diese Regel bereits an.
Was mehr Speicher bringt
Oberhalb von 48 GB schreibt derzeit kein größeres lokales Modell besseres Deutsch als die besten Q8-Varianten mit rund 30 Milliarden Parametern; die erste Wahl ändert sich deshalb nicht mehr und die oberen Stufen verschmelzen. Zusätzlicher Speicher bringt trotzdem drei Dinge: die Q8-Variante einer Familie statt ihrer Q4 (der Abschnitt zur Quantisierung zeigt, wo das zählt), langen Kontext ohne Ausweichen in den Systemspeicher und Platz für zwei gleichzeitig geladene Modelle. Was er nicht bringt, ist Geschwindigkeit: Die Generierung hängt an der Speicherbandbreite, und eine 24-GB-Karte ist beim selben Modell meist schneller als ein 128-GB-Pool.
Zu den Geschwindigkeitsangaben
Token pro Sekunde wurden auf unserem eigenen Strix-Halo-Rechner gemessen, beschrieben auf der Seite Strix-Halo-Tempo, Reasoning-Token eingeschlossen, bis die lokale Generierung am 22. September 2026 endete. Sie vergleichen Varianten miteinander; sie sagen nichts über Ihren Rechner voraus. Eine dedizierte Karte generiert bei einem Modell, das in ihren Speicher passt, typischerweise zwei- bis viermal schneller als diese Maschine; ein Notebook-Prozessor ohne Beschleuniger deutlich langsamer. Und wenn ein Teil des Modells auf den Prozessor ausgelagert wird, bricht die Geschwindigkeit stark ein, obwohl das Modell technisch „passt“.
Qualität gegen Geschwindigkeit
Beide Größen laufen auf dieser Seite parallel, aber getrennt. Das Ranking bewertet ausschließlich, wie gut die deutschen Texte sind. Wie schnell eine Variante antwortet und wie viel Speicher sie belegt, sind Hardwarefragen – wichtig für die Auswahl, aber kein Qualitätsmerkmal.
Für die Praxis heißt das: Wer redigiert, überarbeitet oder längere Passagen schreiben lässt, fährt meist besser mit der höherwertigen Variante und wartet ein paar Sekunden länger. Wer interaktiv arbeitet, viele kurze Anläufe braucht oder in einem Editor mitschreiben lässt, wird die schnellere Alternative bevorzugen. Beide Wege stehen in jedem Speichersegment nebeneinander.
Häufige Fragen
Welche lokale KI schreibt am besten auf Deutsch?
Die Zusammenfassung oben nennt die derzeit bestplatzierte Variante mit ihrer Bewertung; sie wird bei jeder Aktualisierung neu ermittelt. Übernehmen Sie nicht nur den Modellnamen, sondern auch Quantisierung und Reasoning-Einstellung. Und die beste Variante ist nur dann die richtige, wenn sie mit Reserve für Ihren Kontext in Ihren Speicher passt; für die meisten Leser sind die Empfehlungen nach Speichergröße nützlicher.
Wie viel VRAM brauche ich mindestens?
Der konkrete Bedarf hängt von Variante und Kontext ab. Die Hardware-Empfehlungen oben zeigen für 8 bis 128 GB, welche bewertete Variante mit der angesetzten Reserve hineinpasst; fehlt eine belastbare Empfehlung, bleibt die Karte leer. Rechnen Sie zusätzlich Platz für den KV-Cache ein, wenn Sie mit langem Kontext arbeiten.
Ist gemeinsamer Speicher (Unified Memory) so gut wie VRAM?
Bei der Kapazität oft besser: Rechner mit gemeinsamem Speicher fassen Modelle, die auf keine Grafikkarte für Privatanwender passen. Bei der Bandbreite in der Regel nicht, und das zeigt sich als langsamere Generierung. Setzen Sie beides nicht gleich.
Ist Q4 schlechter als Q8?
Es kann schlechter sein, aber Richtung und Stärke hängen vom Modell, vom Verfahren und von der Aufgabe ab. Q4 QAT und nachträgliches Q4_K_M sind dabei nicht gleichzusetzen. Belastbare Aussagen machen wir nur dort, wo uns direkte Vergleiche desselben Checkpoints mit derselben Reasoning-Einstellung vorliegen.
Warum stehen Modelle ab 256 Milliarden Parametern nicht im Ranking?
Weil diese Seite auf persönliche Rechner und kompakte Workstations begrenzt bleibt; größere Systeme sind damit nicht grundsätzlich unmöglich. Die Grenze bezieht sich auf die Gesamtparameter, auch bei Mixture-of-Experts-Modellen – der Speicherbedarf richtet sich nach ihnen, nicht nach den aktiven Parametern.
Warum werden Varianten desselben Modells getrennt gelistet?
Weil sie sich unterschiedlich verhalten. Eine Q8-Variante mit Reasoning ist ein anderes System als eine Q4-Variante ohne. Ein Durchschnittswert über beide würde Ihnen genau die Information nehmen, die Sie zum Herunterladen brauchen.
Was bedeutet „Nicht angegeben“ im Reasoning-Filter?
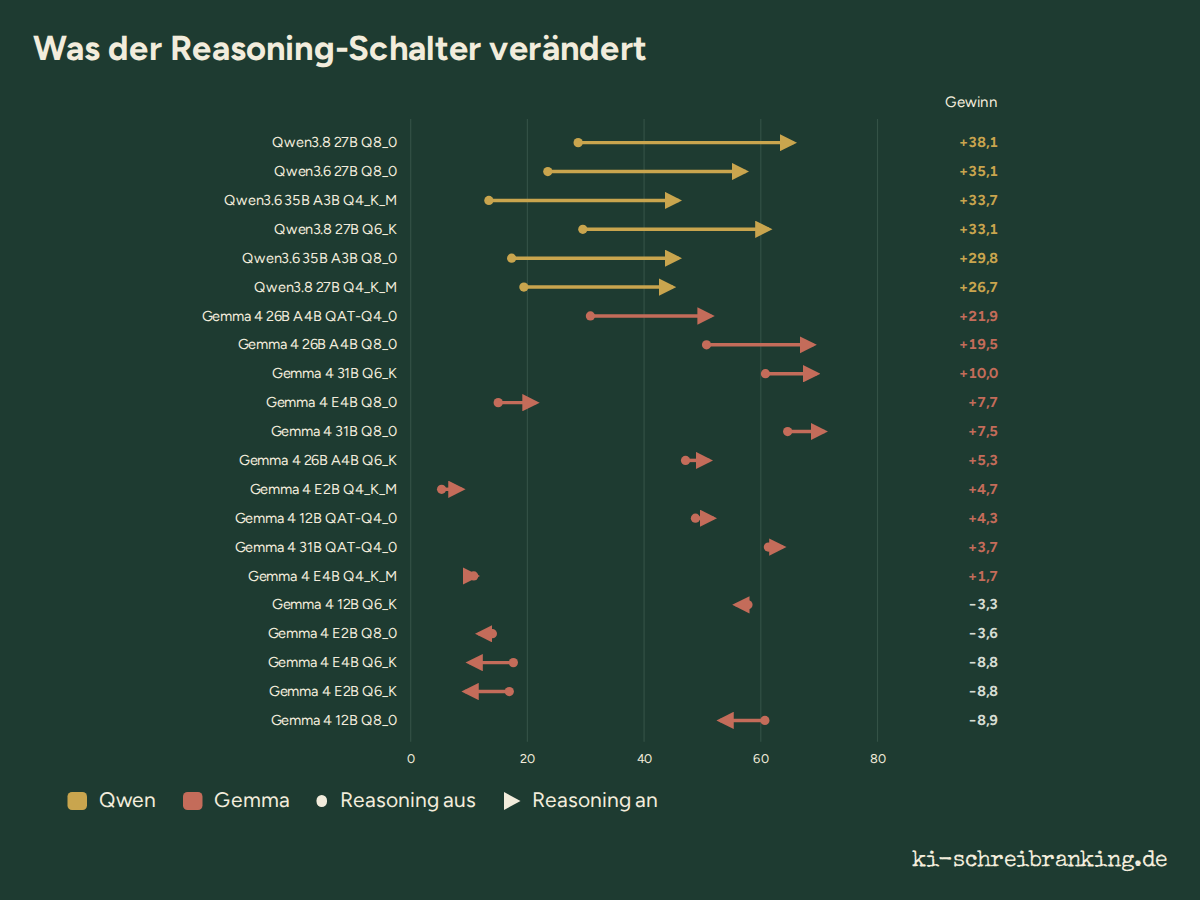
Dass wir aus den vorliegenden technischen Belegen nicht sicher ableiten können, ob während der Generierung tatsächlich Reasoning stattfand. Eine entsprechende Anforderung in der Konfiguration genügt uns nicht als Nachweis, wenn die Laufzeitumgebung keine Reasoning-Token meldet.
Zählt es gegen ein Modell, wenn es auch gegen Cloud-Modelle antreten musste?
Nein. Die Bewertungen stammen aus dem gemeinsamen deutschen Ranking, damit alle Varianten auf derselben Skala und mit möglichst vielen Vergleichen bewertet werden. Für diese Seite wird nur gefiltert und neu nummeriert.
Sind offene Gewichte dasselbe wie Open Source?
Nein. Offene Gewichte bedeuten, dass Sie das Modell herunterladen und lokal ausführen können. Ob die Lizenz frei ist und ob Trainingsdaten offenliegen, ist davon unabhängig – und sollte für kommerzielle Nutzung separat geprüft werden.
Wie oft wird diese Seite aktualisiert?
Laufend. Rangliste, Filter und Hardware-Empfehlungen entstehen aus den aktuellen Daten, und neue Urteile fließen bei jeder Aktualisierung ein. Neue lokale Antworten erzeugen wir seit dem 22. September 2026 nicht mehr; die vorhandenen werden aber weiter beurteilt, deshalb können sich Bewertungen und Ränge weiter verschieben.