Die Modelle werden nach der Qualität ihrer deutschen Texte geordnet. Mit den Filtern lässt sich die Liste eingrenzen. Für die ausgewählten Schreibkategorien werden die Ränge vor den Filtern für Anbieter, Größe, Zugang, Reasoning und Quantisierung berechnet; ausgeblendete Modelle können daher Lücken hinterlassen.
Zuletzt aktualisiert:
Rangliste der Schreibmodelle auf Basis paarweiser Ergebnisse
Rang
Modell
KI-
Bewertung
Menschliche
Bewertung
1
GPT-6.1 Sol 💡 high
97,0
—
2
Claude Opus 5.5 💡 adaptive high
96,4
—
3
GPT-6 Astra 💡 high
95,6
—
4
Claude Fable 5.1 💡 adaptive high
95,5
—
5
Claude Opus 5 💡 adaptive high
95,1
—
6
Claude Fable 5 💡 adaptive high
94,7
—
7
Kimi K3 💡 enabled
93,3
—
8
Muse Spark 1.2 💡 high
90,7
—
9
GPT-6 Sol 💡 high
90,4
—
10
GPT-5.6 Sol 💡 high
90,2
—
11
DeepSeek V4.1 Flash 💡 high
89,6
—
12
Gemini 3.8 Flash 💡 high
89,4
—
14
Grok 4.7 💡 high
88,7
—
15
Claude Sonnet 5.5 💡 adaptive high
88,6
—
16
Gemini 3.7 Flash 💡 medium
88,4
—
17
Muse Spark 1.3 💡 high
87,1
—
18
GLM 5.3 💡 max
86,9
—
19
Claude Haiku 5.5 💡 adaptive high
83,4
—
20
Qwen3.8 Max 💡 xhigh
82,5
—
21
Hy4 Preview 💡 high
81,3
—
23
GPT-6 Luna 💡 high
80,0
—
24
Claude Sonnet 5 💡 adaptive high
79,2
—
25
Qwen3.7 Max 💡 enabled
78,5
—
25
Aion 3.5 💡 high
78,5
—
27
GPT-5.6 Luna 💡 high
77,8
—
28
GPT-5.6 Terra 💡 high
77,7
—
29
Inkling 💡 high
74,8
—
30
Mistral Large 4 💡 high
73,6
—
31
MiniMax M3 💡 enabled
70,8
—
32
DeepSeek V4 Flash 💡 enabled
69,6
—
33
Gemma 4 31B Q8_0 💡 on* 🏠
68,9
46,3
34
Aion 3.0 💡 mandatory
68,7
—
35
Hy3 💡 high
68,5
—
36
GLM 5.2 💡 enabled
67,9
—
37
Gemma 4 26B A4B Q8_0 💡 on* 🏠
66,8
50,3
38
MiMo V2.6 Pro fp8 💡 high
66,1
—
39
Ling 3.1 Flash 💡 high
65,1
—
42
Qwen3.7 Plus 💡 enabled
63,1
—
44
Qwen3.8 27B Q8_0 💡 xhigh** 🏠
60,8
—
46
MiMo V2.5 Pro 💡 enabled
60,0
—
49
Gemma 4 12B Q8_0 ↯ 🏠
59,2
—
50
Gemma 4 31B Q8_0 ↯ 🏠
58,0
—
52
DeepSeek V4 Pro 💡 enabled
56,9
—
53
Qwen3.6 27B Q8_0 💡 on* 🏠
55,0
32,3
56
Nemotron 3 Ultra 💡 high
52,7
—
59
Gemma 4 12B Q8_0 💡 on* 🏠
50,9
—
59
Qwen3.8 Flash 💡 high
50,9
—
62
Grok 4.6 💡 high
47,7
—
63
GLM 5.3 Flash 💡 high
46,7
—
66
Gemma 4 26B A4B Q8_0 ↯ 🏠
45,8
—
69
Mistral Medium 3.5 💡 high
40,7
—
69
Qwen3.6 35B A3B Q8_0 💡 on* 🏠
40,7
67,7
74
Seed 2.1 Turbo ↯
36,9
—
75
MiMo V2.6 Flash 💡 high
29,8
—
77
Qwen3.8 27B Q8_0 ↯ 🏠
25,0
—
78
MiniMax M3.1 Flash 💡 high
24,2
—
79
MiMo V2.5 💡 enabled
23,7
—
80
Agnes 3.0 Flash 💡 high
22,8
—
83
Qwen3.6 27B Q8_0 ↯ 🏠
20,8
—
84
Gemma 4 E4B Q8_0 💡 on* 🏠
18,8
—
86
Nemotron 3.5 Lightning 💡 high
16,7
—
90
Qwen3.6 35B A3B Q8_0 ↯ 🏠
12,5
—
91
Gemma 4 E4B Q8_0 ↯ 🏠
12,1
—
93
Gemma 4 E2B Q8_0 💡 on* 🏠
11,0
—
96
Gemma 4 E2B Q8_0 ↯ 🏠
10,7
—
103
Granite 4.2 30B Q8_0 💡 full 🏠
5,4
—
105
Nemotron 3 Nano Omni 30B A3B Q8_0 💡 on* 🏠
4,9
—
108
Granite 4.2 8B Q8_0 💡 full 🏠
1,6
—
Für diese Auswahl liegt noch kein veröffentlichtes Ergebnis vor
Ein Modell erscheint nach seiner ersten veröffentlichten Einzelbewertung; sein Ranglistenwert nach seinem ersten zulässigen Duell.
108 verglichene Modelle · 115.703 veröffentlichte KI-Urteile
Methode: regularisiertes Bradley–Terry-Modell. Die KI-Bewertung bestimmt den Rang; die menschliche Bewertung ist davon unabhängig und bleibt nachrangig, bis mehr Stimmen aus dem Publikum vorliegen. Eine Bewertung von 50 bedeutet, dass ein Modell das durchschnittliche Modell dieser Sprache und Kategorie schätzungsweise in der Hälfte der Duelle schlägt.
Ergebnisse der direkten Duelle
Jede Zelle zeigt den Anteil der möglichen Punkte, den das Zeilenmodell gegen das Spaltenmodell erzielt: Ein Sieg zählt 100 %, ein Unentschieden 50 %, eine Niederlage 0 %. Diese Ergebnismatrix verwendet nur die mit der Hauptrangliste kompatiblen Bewertungsprotokolle.
Gerichtete Matrix der in direkten Duellen erzielten Punkte. Werte über 50 % sprechen für das Zeilenmodell, Werte darunter für das Spaltenmodell.
0 %100 %
💡 kennzeichnet ein Modell mit Reasoning, ↯ eines ohne Reasoning. 🏠 kennzeichnet ein Modell, das lokal ausgeführt wurde: auf dem Rechner des Autors dieser Website.„on*“ bedeutet, dass sich Reasoning nur ein- oder ausschalten lässt (lokale Modelle ohne Zwischenstufen): Die lokale Datei unterstützt die angeforderte Feineinstellung nicht und fällt auf den standardmäßig aktivierten Modus zurück. Bei lokalen Modellen mit einstellbarem Reasoning (Qwen3.8, Muse Glimmer, Granite 4.2, Nemotron 3 Super, K2 Horizon, Ling 3.0 Flash) ist das angezeigte Niveau (xhigh**, high, full) das Standardniveau des Modells: Die lokale Datei unterstützt die angeforderte Feineinstellung nicht und fällt auf ihr Standardverhalten zurück.
Als Tabelle anzeigen
In direkten Duellen erzielte Punkte je Modellpaar
Modell
Abdeckung der veröffentlichten Duelle
Jede Zelle zeigt, wie viele veröffentlichte, KI-bewertete Duelle über alle Protokolle hinweg die beiden Modelle für diese Sprache und Kategorie vergleichen. Die Modelle auf beiden Achsen sind Kandidaten; die Matrix zeigt nicht, welcher Juror das jeweilige Urteil gefällt hat.
Symmetrische Matrix der veröffentlichten Duellzahlen. Die Diagonale ist null, weil ein Modell nicht mit sich selbst verglichen wird.
0
💡 kennzeichnet ein Modell mit Reasoning, ↯ eines ohne Reasoning. 🏠 kennzeichnet ein Modell, das lokal ausgeführt wurde: auf dem Rechner des Autors dieser Website.„on*“ bedeutet, dass sich Reasoning nur ein- oder ausschalten lässt (lokale Modelle ohne Zwischenstufen): Die lokale Datei unterstützt die angeforderte Feineinstellung nicht und fällt auf den standardmäßig aktivierten Modus zurück. Bei lokalen Modellen mit einstellbarem Reasoning (Qwen3.8, Muse Glimmer, Granite 4.2, Nemotron 3 Super, K2 Horizon, Ling 3.0 Flash) ist das angezeigte Niveau (xhigh**, high, full) das Standardniveau des Modells: Die lokale Datei unterstützt die angeforderte Feineinstellung nicht und fällt auf ihr Standardverhalten zurück.
Als Tabelle anzeigen
Veröffentlichte Duelle je Modellpaar
Modell
Helfen Sie mit, das beste Schreibmodell für Deutsch zu küren
Welches Modell schreibt den besseren Text? Beurteilen Sie dieses anonyme Paar und tragen Sie zur menschlichen Rangliste bei. Im Textduell sehen Sie nicht, welches Modell welchen Text geschrieben hat. Die Namen erscheinen erst nach Ihrer Wahl.
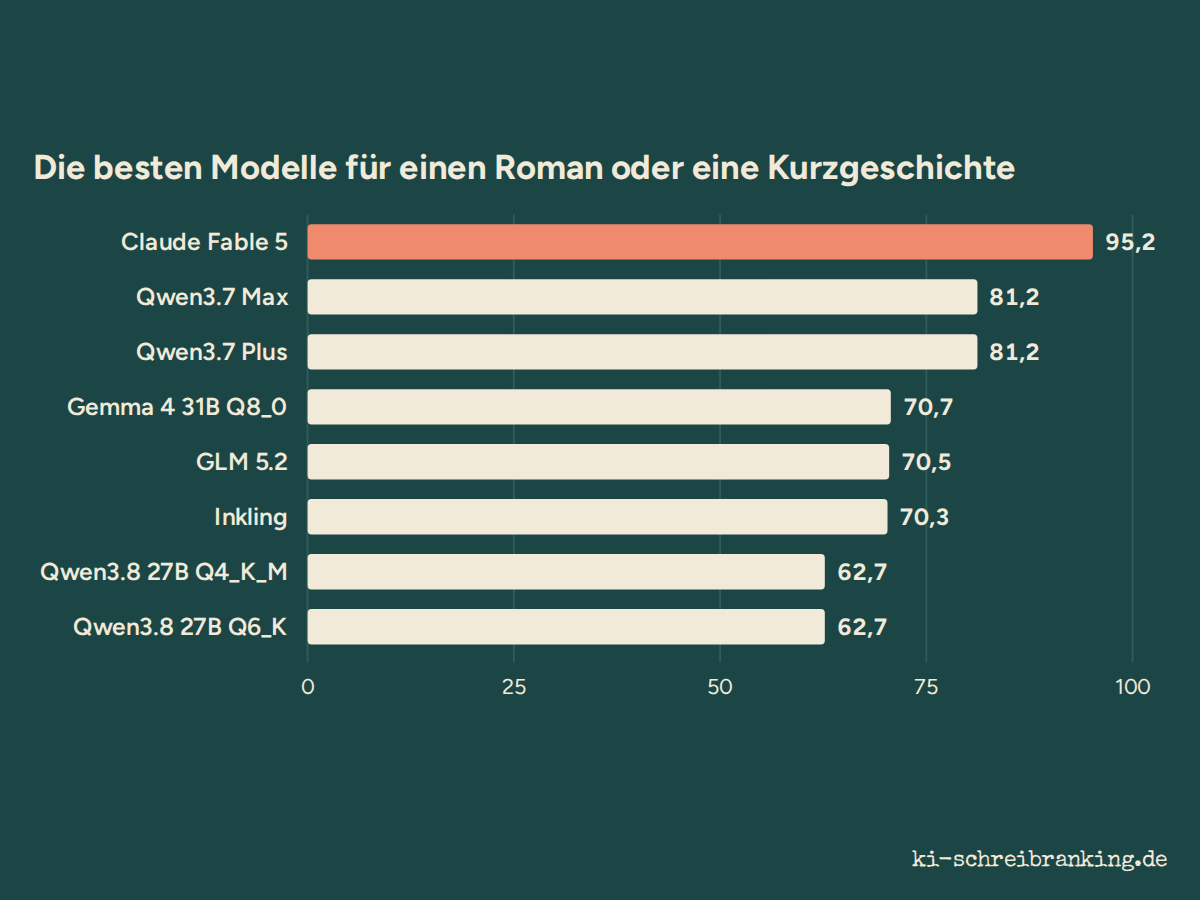
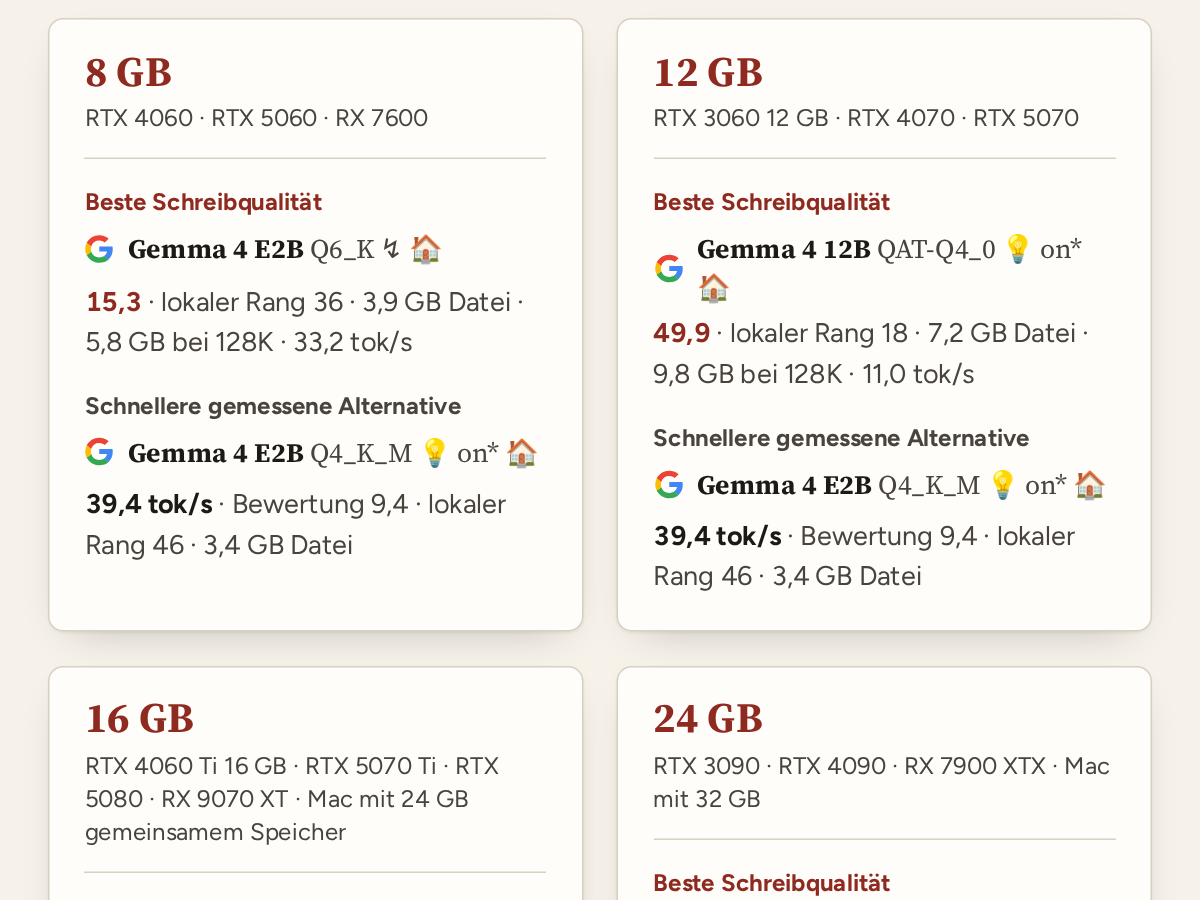
Die Rangliste hat einen Sieger; Ihre Texte haben viele. Allein auf den Duellen einer Textsorte gewinnt Claude Fable 5 Fiktion und Erklärung, Claude Opus 5 persönliche Briefe, und bei Bewerbungen liegen Claude Fable 5 und GPT-5.6 Sol gleichauf. Ein einfacher Leitfaden, Aufgabe für Aufgabe, mit der besten Datei für den eigenen Rechner.
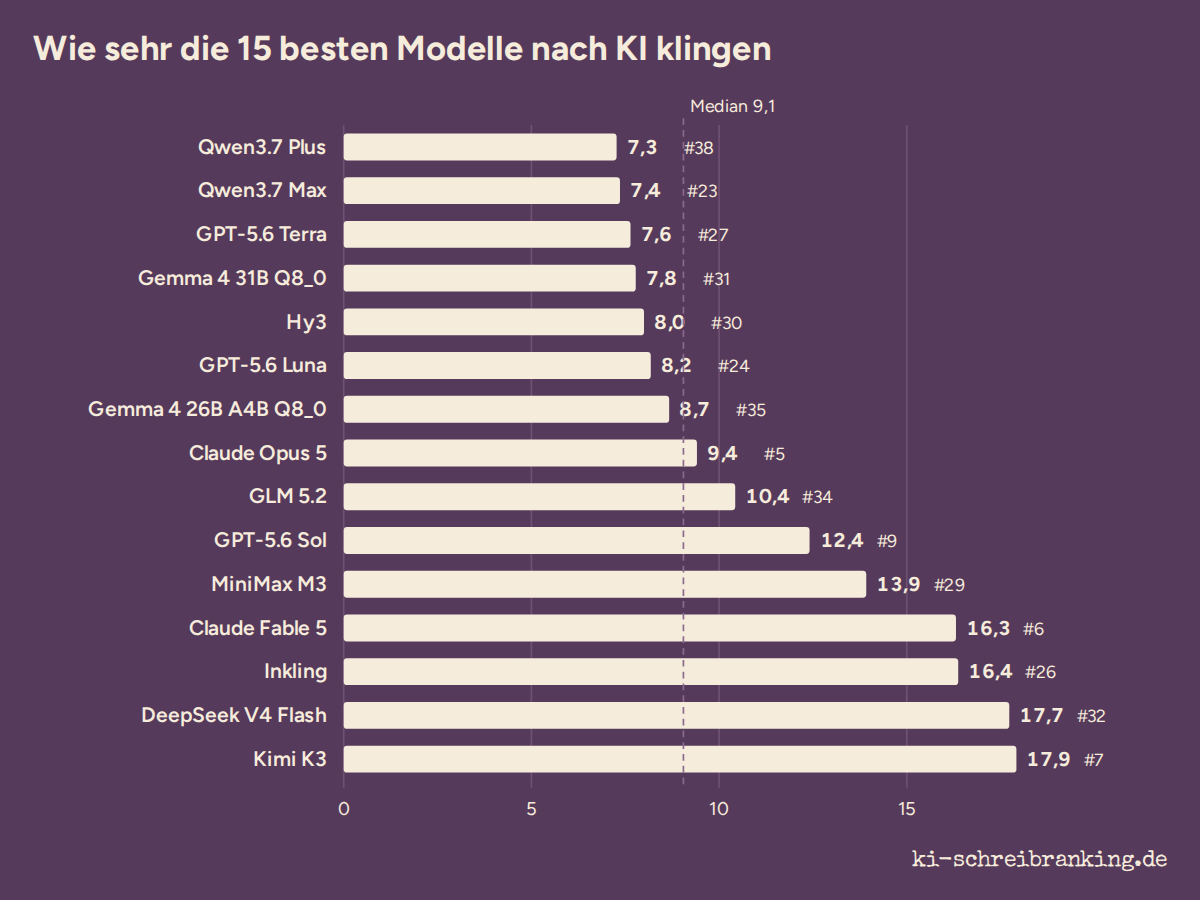
Wir haben in 3.182 gewerteten deutschen Texten gezählt, was Leser „KI-Prosa“ nennen: Gedankenstriche, Floskeln, „nicht X, sondern Y“, Dreierlisten, Anglizismen. Kimi K3 und Claude Fable 5, damals Platz 5 und 3, setzen alle 70 bis 80 Wörter einen Gedankenstrich; Claude Opus 5, damals Erster, deutlich seltener. Und „zudem“ steht 257-mal im Korpus.
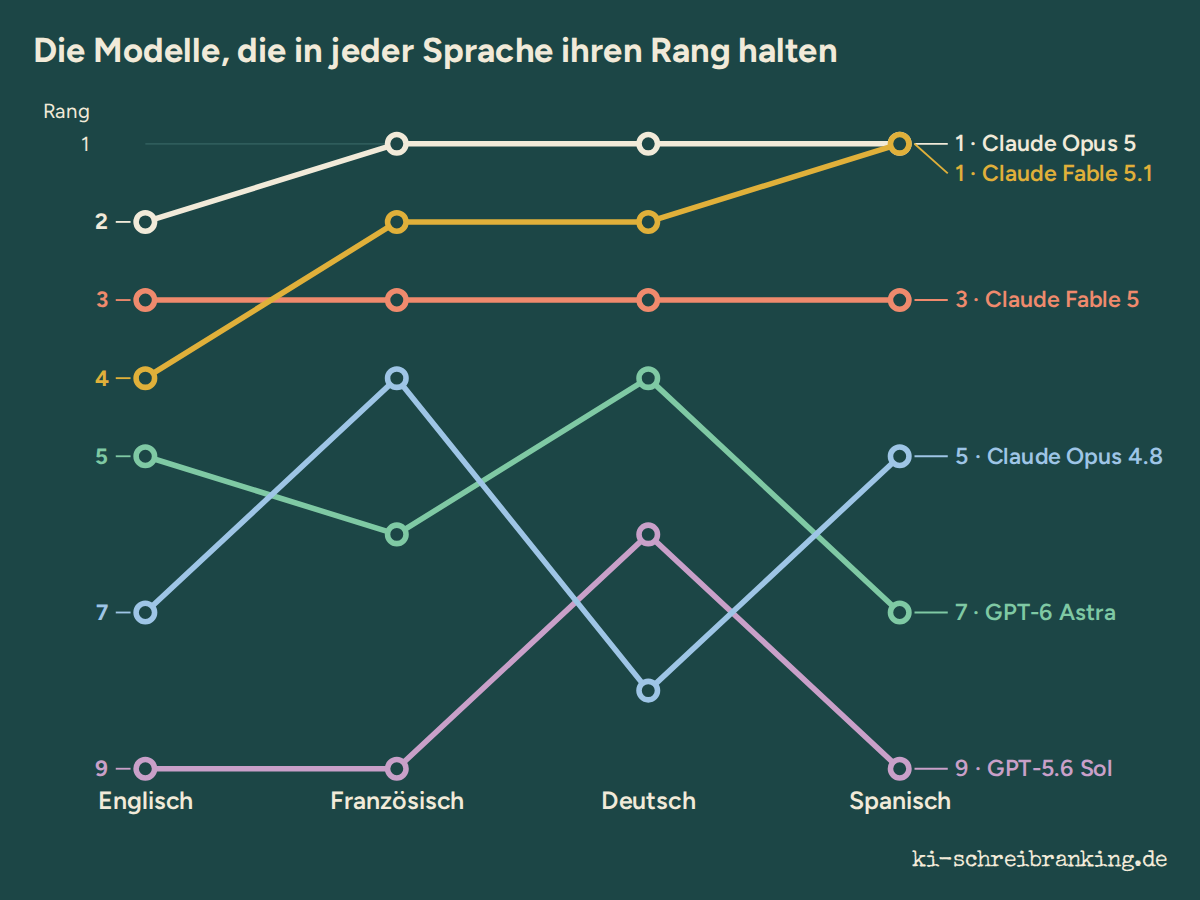
91 Modelle sind auf Englisch, Französisch, Deutsch und Spanisch nach demselben Verfahren eingestuft. Am 19. September war Claude Fable 5 in allen vier Sprachen Dritter, Claude Opus 5 auf Deutsch Erster. Darunter war GLM 5.3 Flash auf Englisch Zehnter und auf Deutsch 54., und die beste lokale Datei ist in jeder Sprache eine andere: auf Deutsch Gemma 4 31B.
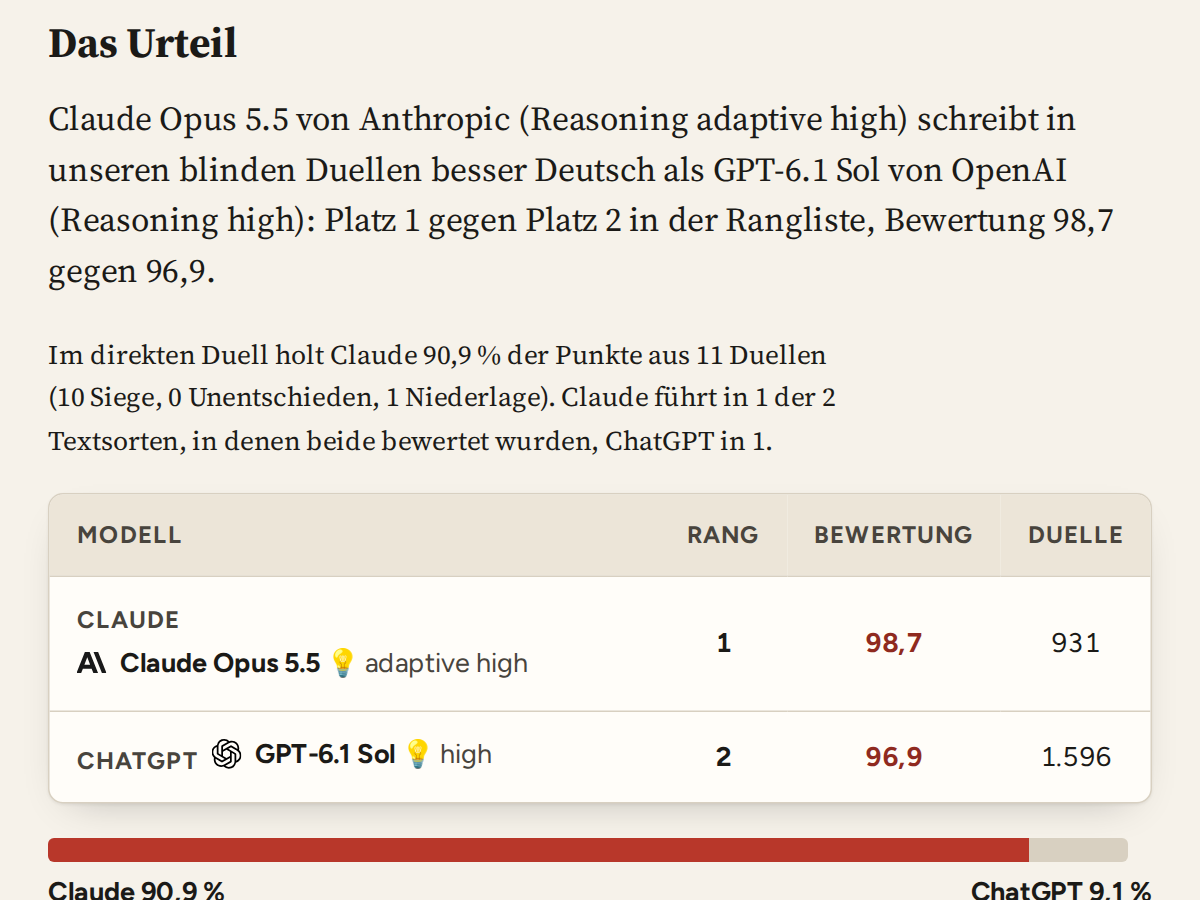
Die beiden meistgefragten Assistenten, auf denselben deutschen Aufgaben in blinden Duellen beurteilt: wer besser schreibt, um wie viel, und bei welchen Textsorten. Mit jeder Aktualisierung der Rangliste neu berechnet.