Lokale KI
Das laufend aktualisierte Schreibranking für Open-Weight-Modelle, mit Quantisierungsfiltern und Speicherempfehlungen.
Datenbasierte Analysen dazu, wie Modelle, Generierungseinstellungen und Bewertungsprotokolle die Textqualität beeinflussen.
Das laufend aktualisierte Schreibranking für Open-Weight-Modelle, mit Quantisierungsfiltern und Speicherempfehlungen.
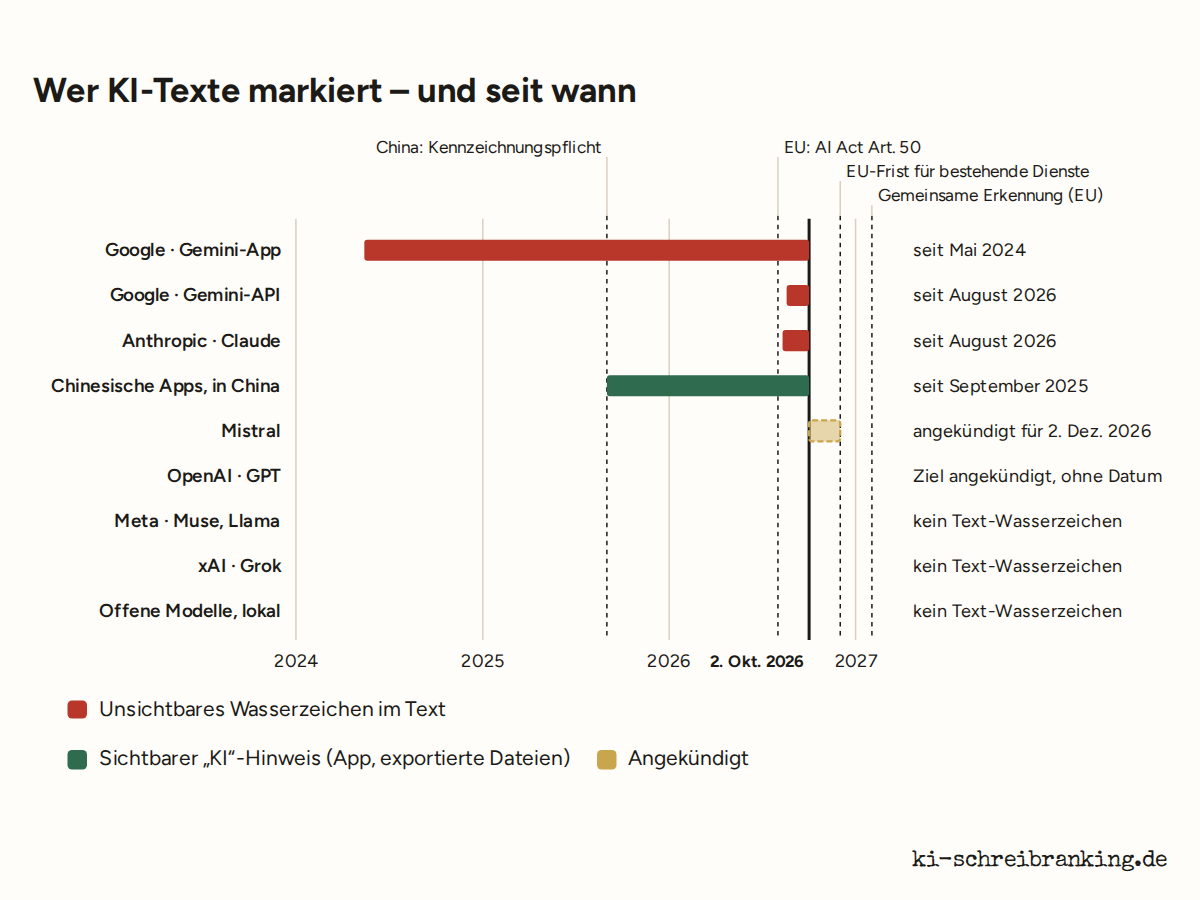
Seit diesem Sommer tragen Texte von Claude und Gemini ein unsichtbares Zeichen; seit dem 5. Oktober tragen es in der EU auch Texte von ChatGPT und Codex, und in der API von OpenAI kann die Markierung auf Wunsch dazugeschaltet werden. Texte von Grok, Mistral, Meta AI und lokal betriebenen Modellen tragen keines, chinesische Dienste begnügen sich mit einem sichtbaren Hinweis. Prüfen kann einen Text heute aber niemand außerhalb der Anbieter.
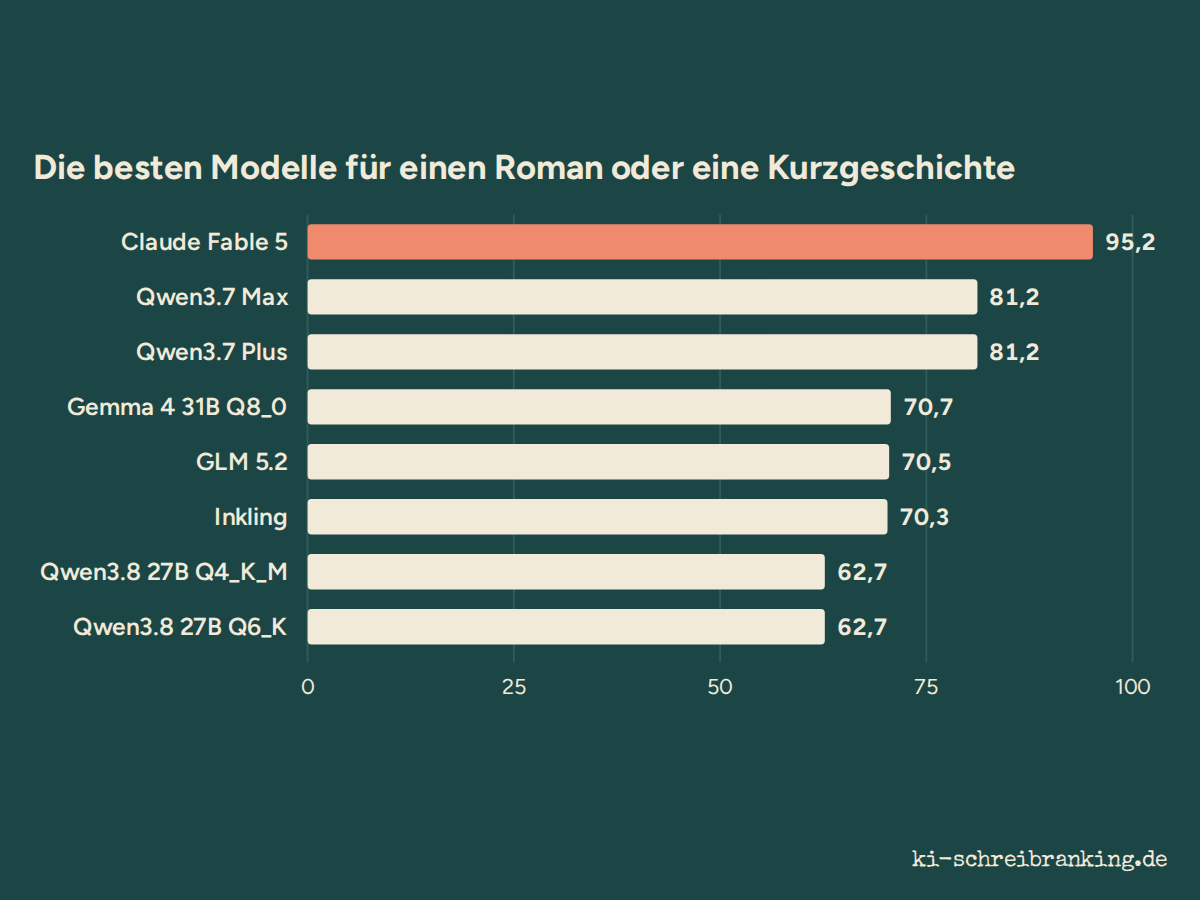
Die Rangliste hat einen Sieger; Ihre Texte haben viele. Allein auf den Duellen einer Textsorte gewinnt Claude Fable 5 Fiktion und Erklärung, Claude Opus 5 persönliche Briefe, und bei Bewerbungen liegen Claude Fable 5 und GPT-5.6 Sol gleichauf. Ein einfacher Leitfaden, Aufgabe für Aufgabe, mit der besten Datei für den eigenen Rechner.
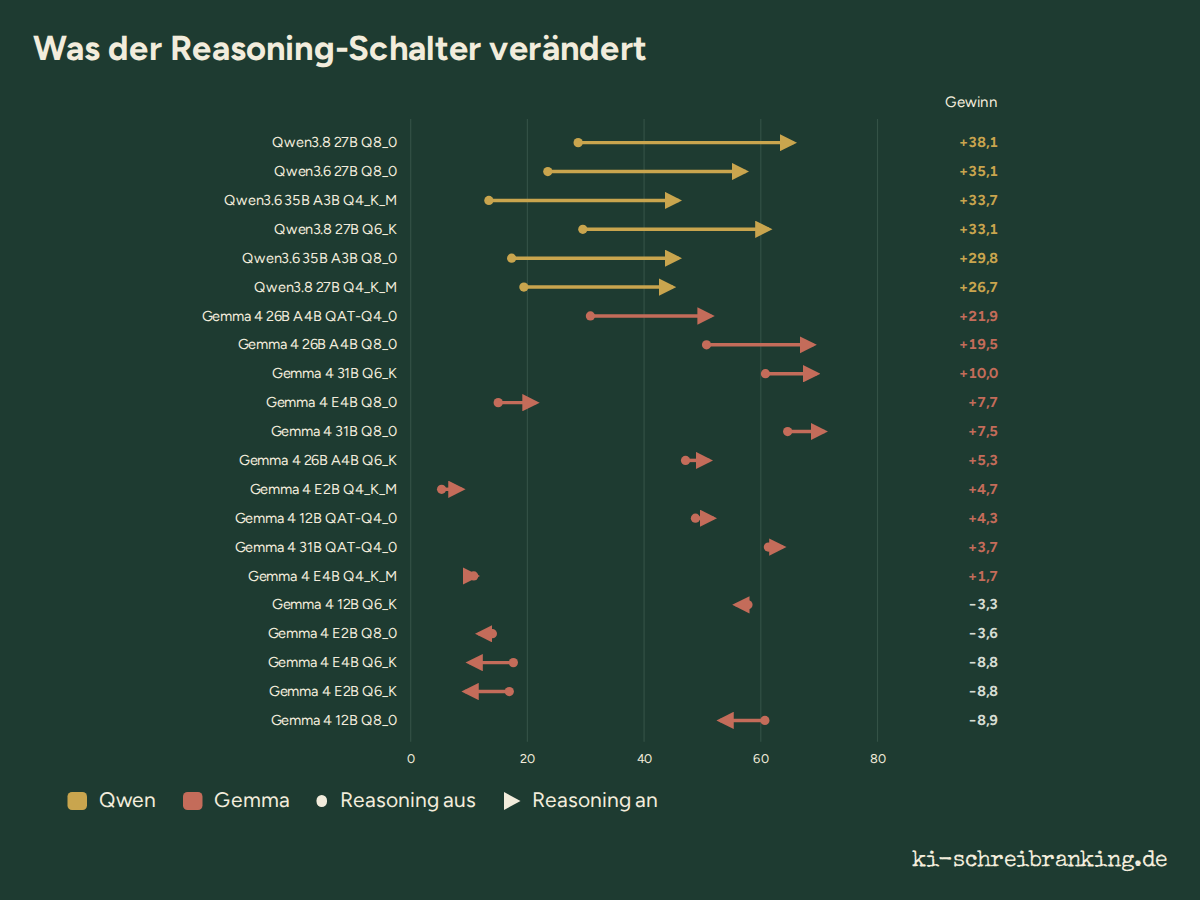
Dieselbe Datei, dieselben Aufgaben, ein Schalter. Über 21 lokale Varianten bringt eingeschaltetes Reasoning der Qwen-Familie im Schnitt 33 Punkte und den Gemma-4-Modellen ab 12B sieben; die kleinen Gemma E2B und E4B verlieren im Schnitt einen Punkt. Qwen3.8 27B Q8_0 gewinnt 38 Punkte, so viel wie kein anderes Modell auf Deutsch.
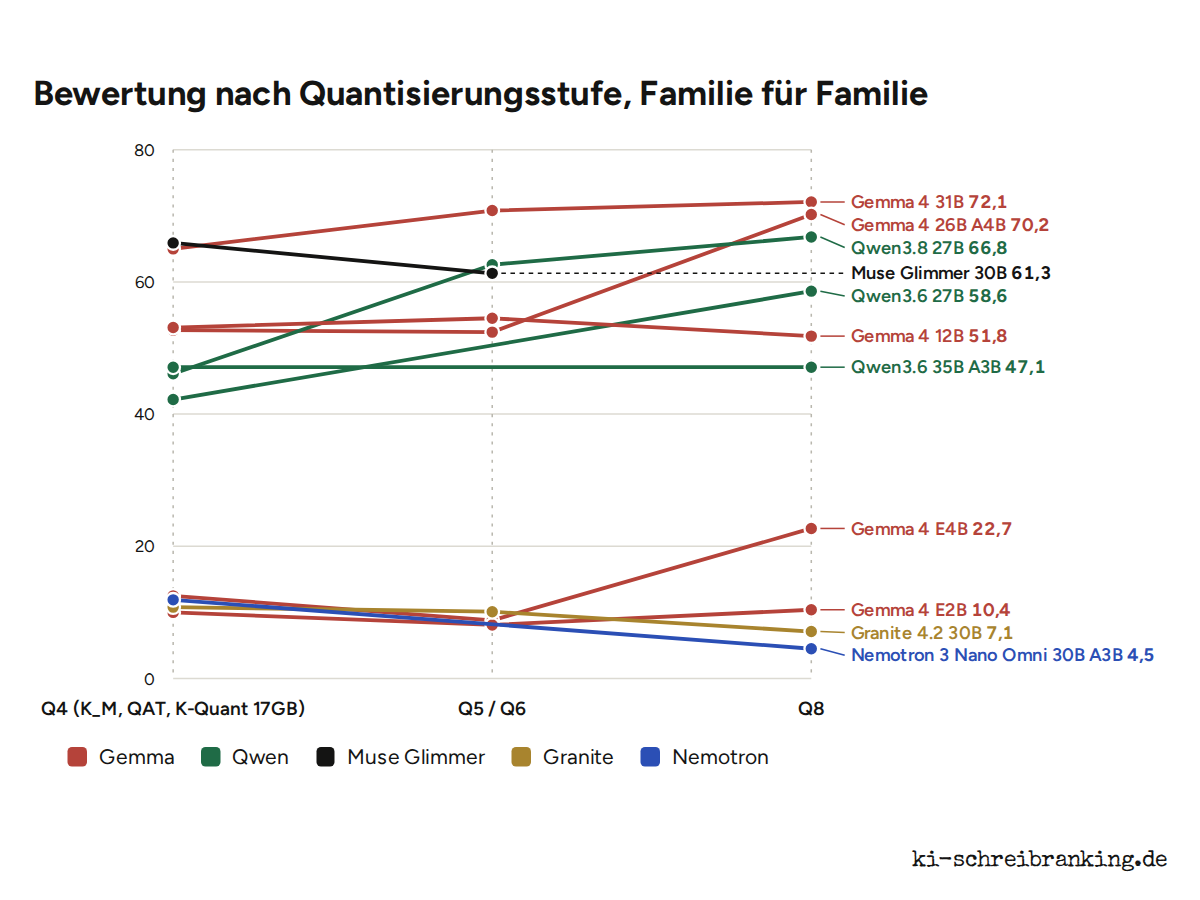
Dasselbe Modell, drei Dateien, drei Bewertungen. Auf Deutsch verliert Qwen3.8 27B 21 Punkte zwischen Q8_0 und Q4_K_M, Gemma 4 26B A4B 18 Punkte, während Gemma 4 31B in Q6 fast so gut schreibt wie in Q8 und Qwen3.6 35B A3B in Q4 und Q8 exakt gleich abschneidet. Eine Faustregel gibt es nicht, nur Messungen.
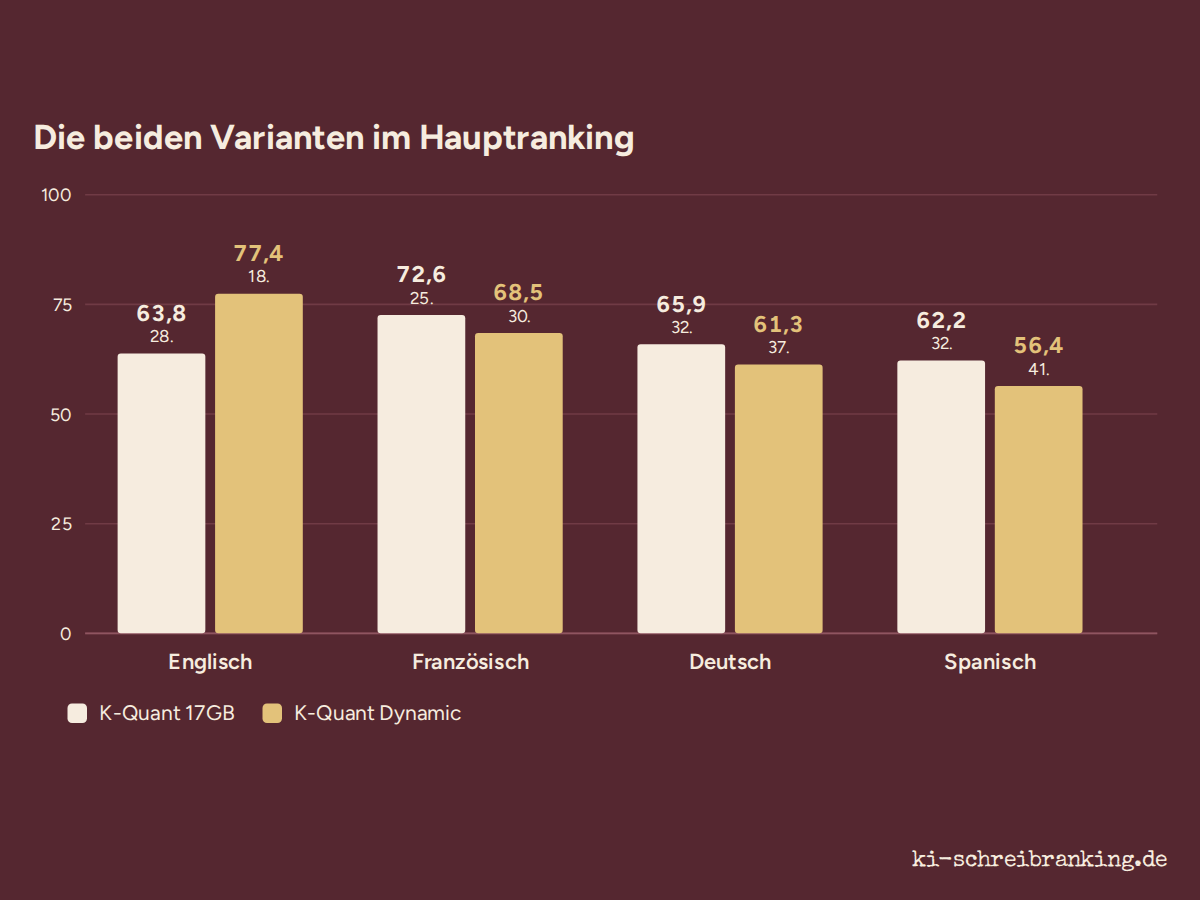
Metas offenes Modell liegt auf Deutsch mit 65,9 Punkten in der K-Quant-17GB-Variante auf Platz 32 des Rankings, die größere Dynamic-Variante mit 61,3 auf Platz 37. Im direkten Duell verliert Dynamic 15 von 26 Runden. Und Gemma 4 31B Q8_0, das beste lokale Modell auf Deutsch, gewinnt gegen beide Muse-Varianten.
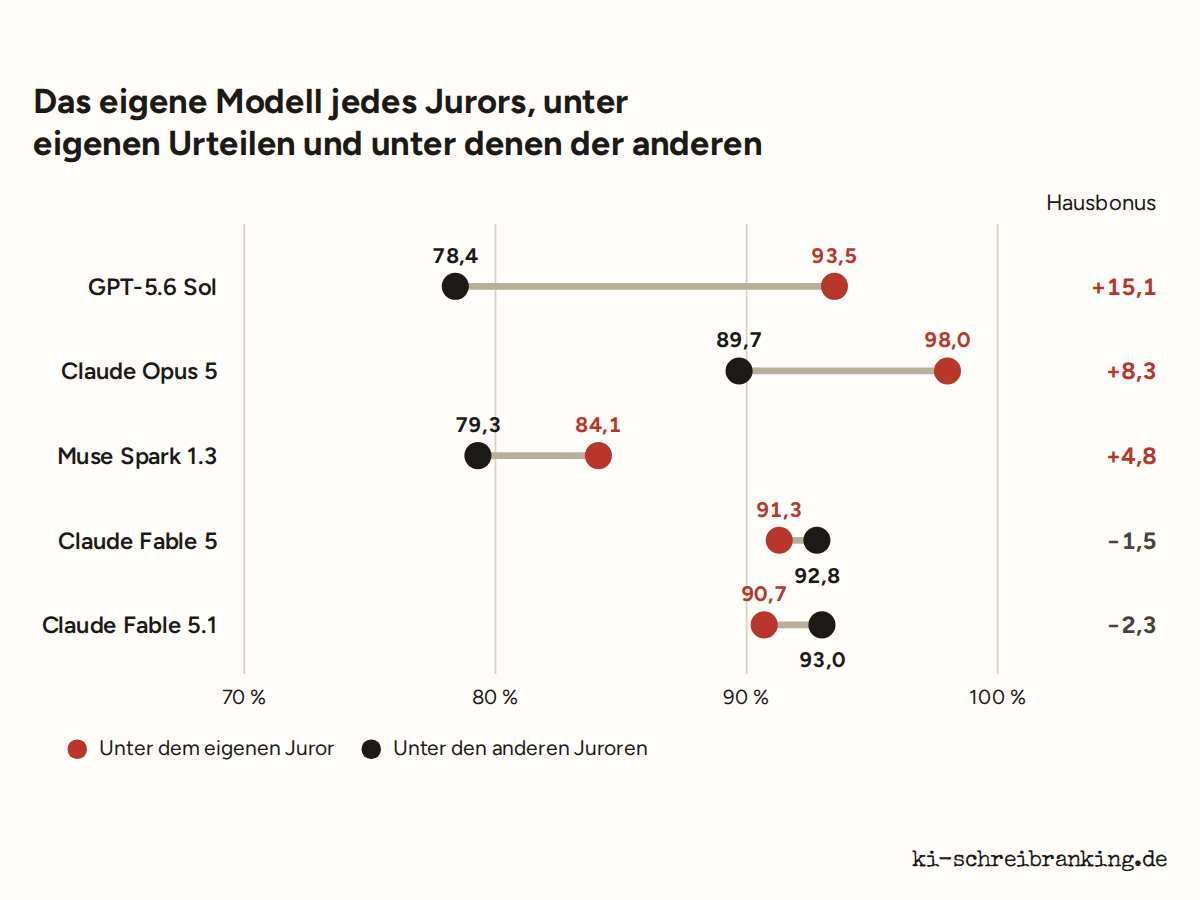
Urteilt GPT-5.6 Sol über ein Duell, in dem GPT-5.6 Sol selbst antritt, holen die eigenen Texte 94 % der Punkte; unter den anderen Juroren sind es 78 %. Claude Opus 5 neigt in dieselbe Richtung, schwächer. Die beiden Claude-Fable-Juroren machen das Gegenteil und bewerten das eigene Modell strenger als die anderen.
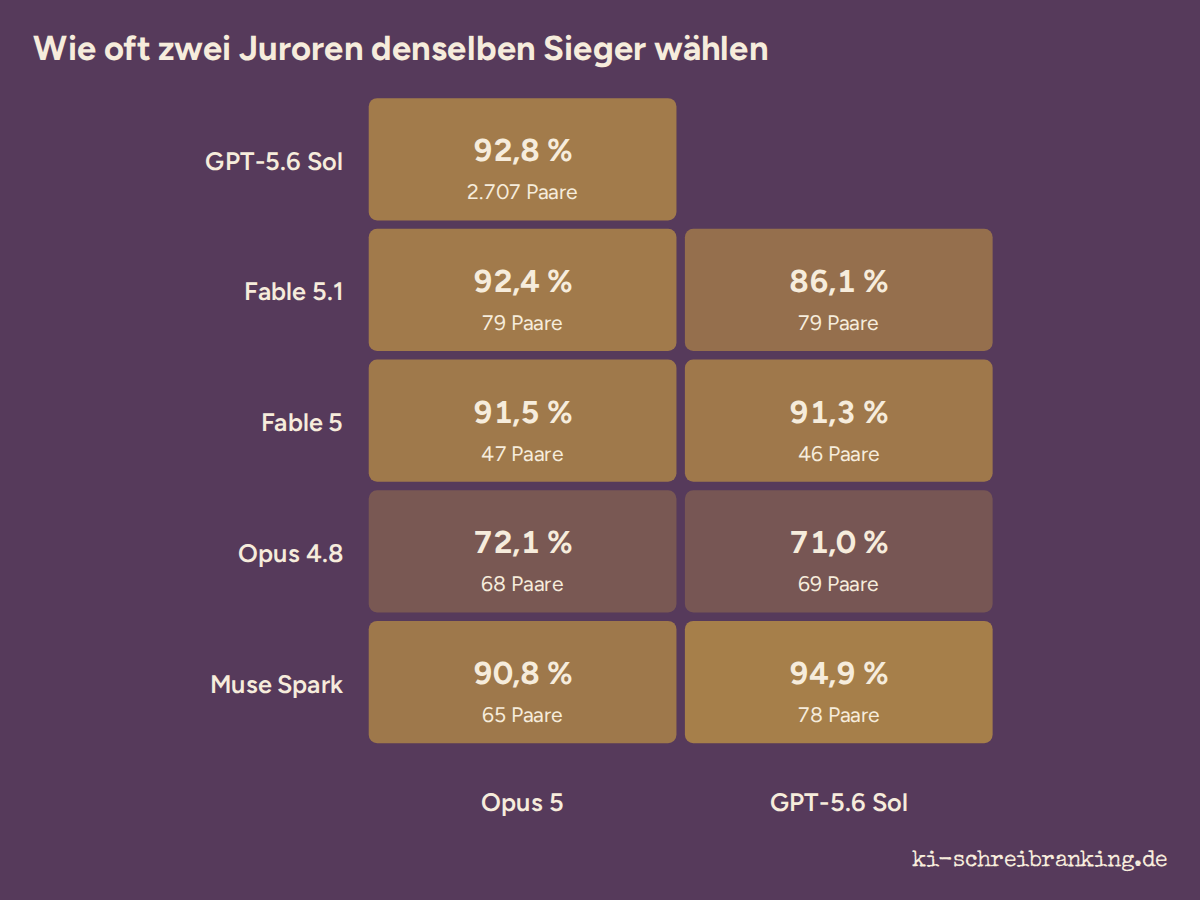
Claude Opus 5 und GPT-5.6 Sol, die bis Mitte September 85 % der Urteile lieferten, geben bei 93 % der 2.700 gemeinsam beurteilten Modellpaare demselben Modell recht. Claude Opus 4.8 folgt ihnen nur in zwei von drei Fällen, und beim Unentschieden ist man sich gar nicht einig: GPT-5.6 Sol vergibt eines pro tausend Duelle, Claude Fable 5.1 eines pro acht.
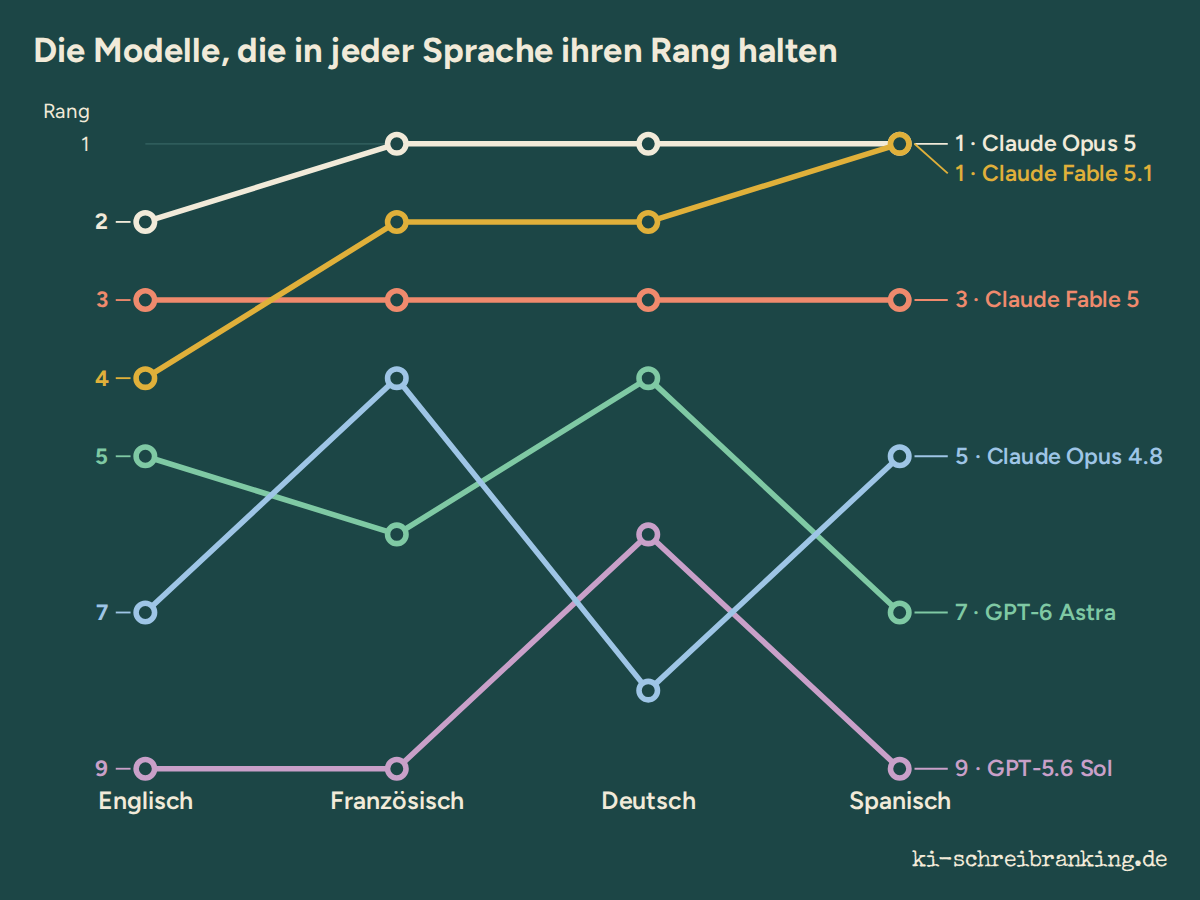
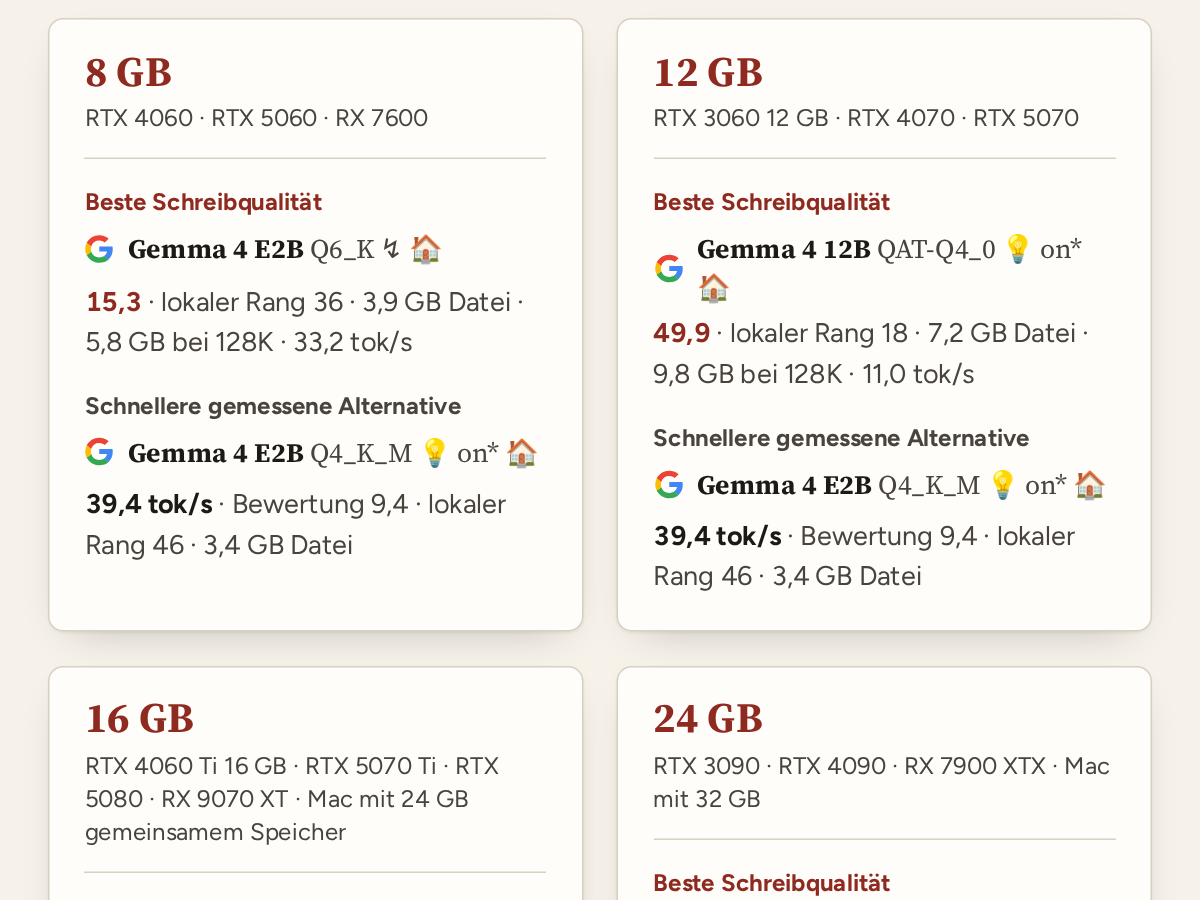
91 Modelle sind auf Englisch, Französisch, Deutsch und Spanisch nach demselben Verfahren eingestuft. Am 19. September war Claude Fable 5 in allen vier Sprachen Dritter, Claude Opus 5 auf Deutsch Erster. Darunter war GLM 5.3 Flash auf Englisch Zehnter und auf Deutsch 54., und die beste lokale Datei ist in jeder Sprache eine andere: auf Deutsch Gemma 4 31B.
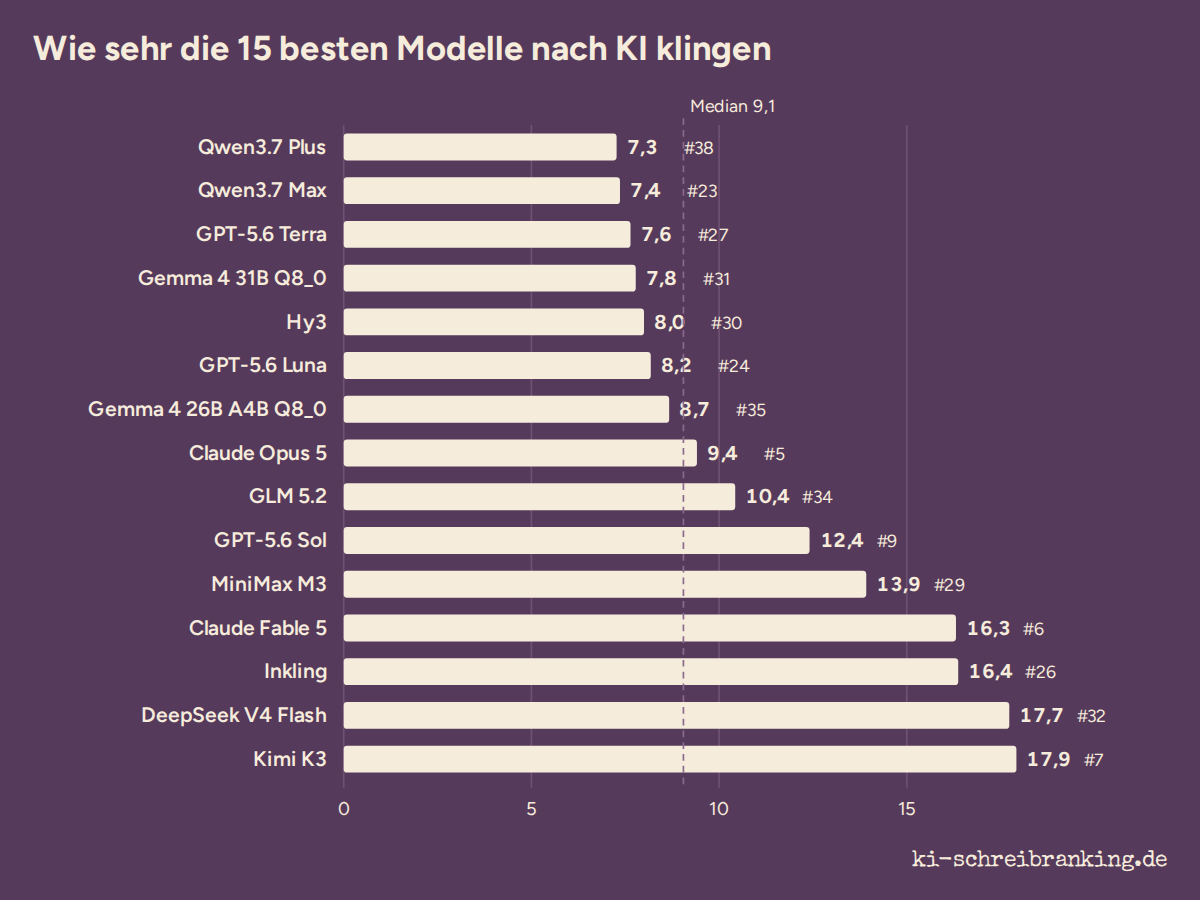
Wir haben in 3.182 gewerteten deutschen Texten gezählt, was Leser „KI-Prosa“ nennen: Gedankenstriche, Floskeln, „nicht X, sondern Y“, Dreierlisten, Anglizismen. Kimi K3 und Claude Fable 5, damals Platz 5 und 3, setzen alle 70 bis 80 Wörter einen Gedankenstrich; Claude Opus 5, damals Erster, deutlich seltener. Und „zudem“ steht 257-mal im Korpus.