





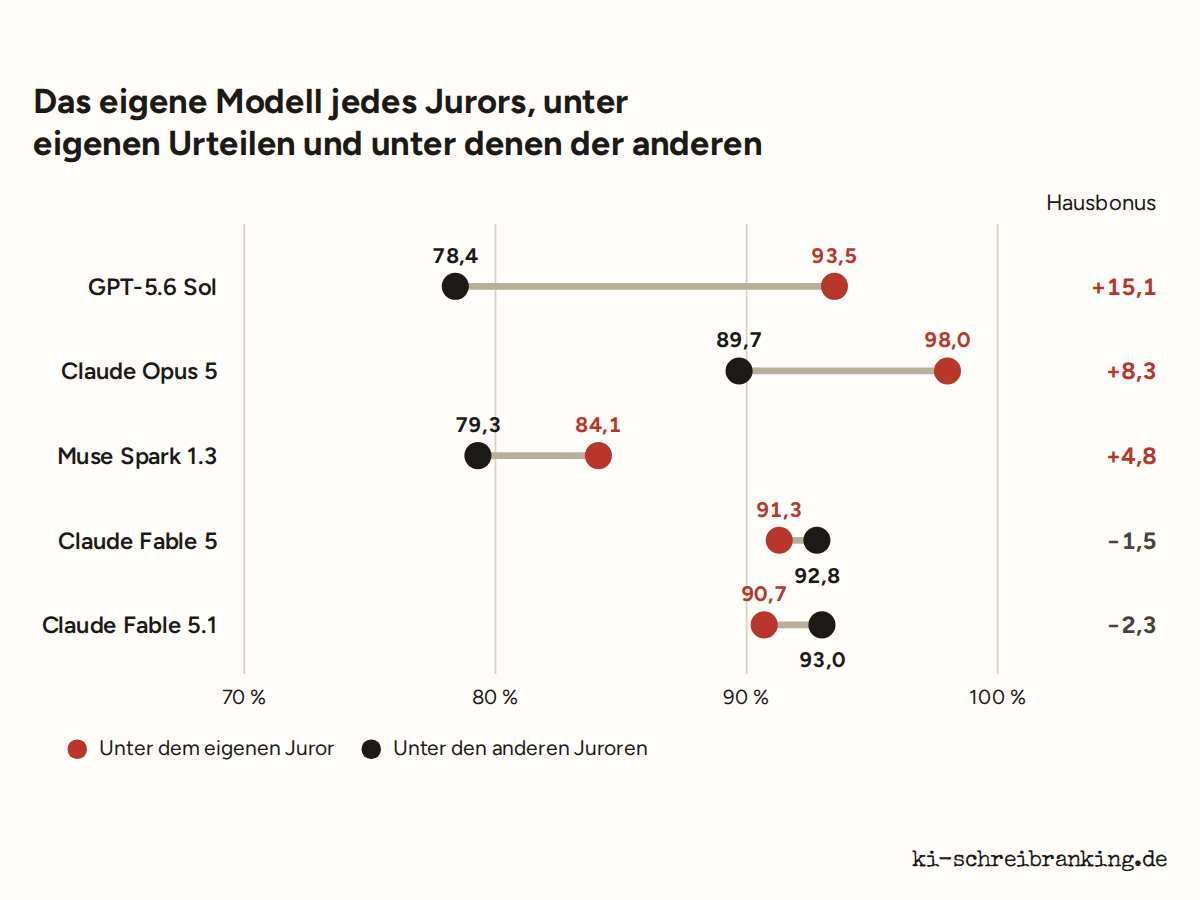
Bevorzugen KI-Juroren das eigene Modell? Zwei von fünf tun es, um bis zu 15 Punkte
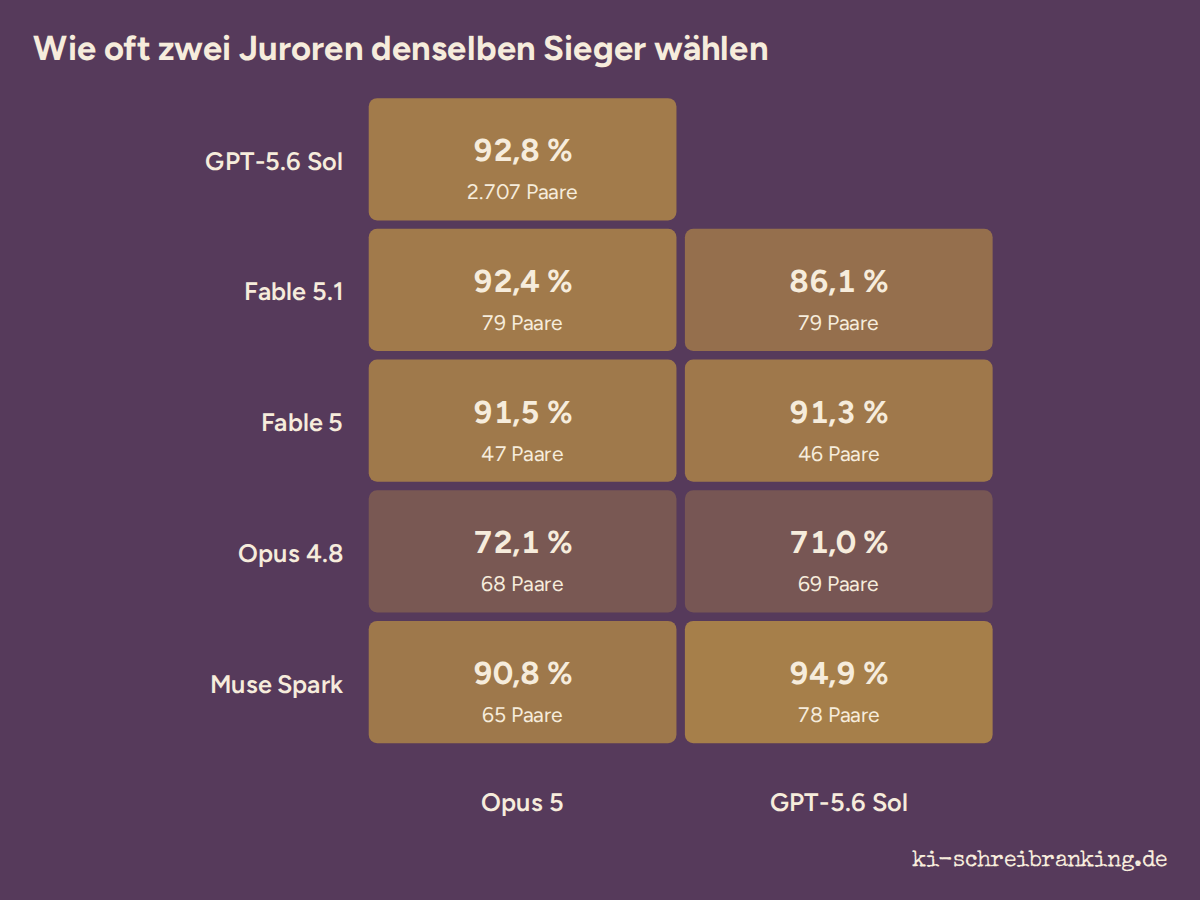
Urteilt GPT-5.6 Sol über ein Duell, in dem GPT-5.6 Sol selbst antritt, holen die eigenen Texte 94 % der Punkte; unter den anderen Juroren sind es 78 %. Claude Opus 5 neigt in dieselbe Richtung, schwächer. Die beiden Claude-Fable-Juroren machen das Gegenteil und bewerten das eigene Modell strenger als die anderen.