Strix Halo ist der Codename von AMDs Ryzen-AI-Max-Serie, dem ersten PC-Chip mit genug gemeinsamem Speicher (Unified Memory) für Modelle, die früher einen Schrank voller Grafikkarten brauchten. Unser Rechner ist ein Framework Desktop: 16 Kerne, eine integrierte Radeon 8060S und 128 GB LPDDR5X, die sich Prozessor und Grafik teilen. Eine verbreitete Konfiguration, etwas über 2.000 Euro, und die Frage dazu ist immer dieselbe: Was läuft darauf, und wie schnell?
Wir können mit Messungen statt Schätzungen antworten, weil das Ranking selbst Tausende Texte darauf erzeugt hat, bis die lokale Generierung am 22. September 2026 endete. Die Tabelle nennt für jede getestete Modelldatei den Median der Token pro Sekunde über die auf dieser Maschine erzeugten gültigen Antworten, Reasoning-Token eingeschlossen, daneben die Dateigröße, den Speicherbedarf bei vollem 128.000-Token-Kontext und die Bewertung des Modells in der Rangliste dieser Ausgabe.
| Modell | Median Tok/s | Datei (GB) | +128K (GB) | Parameter | Bewertung | Antworten |
|---|---|---|---|---|---|---|
 Gemma 4 26B A4B 💡 🏠 | 39,8 | 28,1 | 31,0 | 26,0 B (4,0 B aktiv) | 66,8 | 465 |
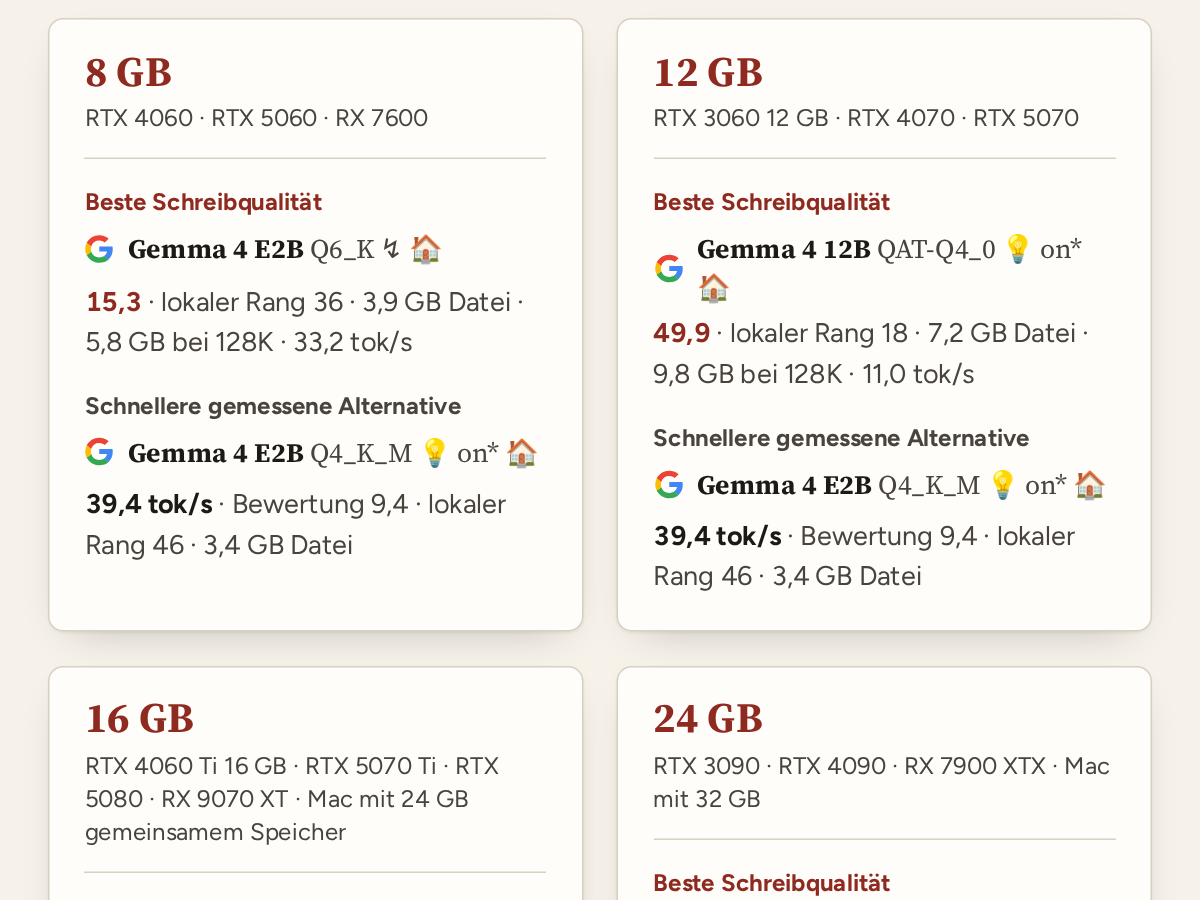
| Gemma 4 E2B 💡 🏠 | 39,4 | 3,4 | 5,3 | 5,1 B | 9,1 | 224 |
| Gemma 4 E4B 💡 🏠 | 35,9 | 8,0 | 11,9 | 8,0 B | 18,8 | 542 |
| Gemma 4 E2B 💡 🏠 | 33,2 | 3,9 | 5,8 | 5,1 B | 10,6 | 216 |
 Ling 3.0 Flash 💡 🏠 | 31,6 | 77,0 | 78,2 | 124,0 B (5,1 B aktiv) | 13,2 | 277 |
| Ling 3.0 Flash ↯ 🏠 | 30,5 | 77,0 | 78,2 | 124,0 B (5,1 B aktiv) | 21,8 | 240 |
| Gemma 4 E2B 💡 🏠 | 29,2 | 5,0 | 6,9 | 5,1 B | 11,0 | 224 |
| Gemma 4 26B A4B 💡 🏠 | 27,9 | 15,6 | 18,6 | 26,0 B (4,0 B aktiv) | 49,1 | 118 |
 Qwen3.6 35B A3B 💡 🏠 | 26,6 | 22,1 | 24,8 | 35,0 B (3,0 B aktiv) | 40,3 | 347 |
 Nemotron 3 Nano Omni 30B A3B 💡 🏠 | 25,1 | 26,1 | 27,0 | 30,0 B (3,0 B aktiv) | 9,6 | 960 |
| Gemma 4 E4B 💡 🏠 | 22,4 | 6,3 | 10,2 | 8,0 B | 10,8 | 221 |
| Qwen3.6 35B A3B 💡 🏠 | 22,1 | 37,8 | 40,6 | 35,0 B (3,0 B aktiv) | 40,7 | 312 |
| Nemotron 3 Nano Omni 30B A3B 💡 🏠 | 21,2 | 35,2 | 36,1 | 30,0 B (3,0 B aktiv) | 4,9 | 391 |
| Nemotron 3 Super 120B A12B 💡 🏠 | 21,1 | 86,1 | 87,5 | 120,0 B (12,0 B aktiv) | 26,8 | 413 |
| Gemma 4 26B A4B 💡 🏠 | 20,2 | 23,8 | 26,8 | 26,0 B (4,0 B aktiv) | 51,7 | 539 |
| Gemma 4 E4B 💡 🏠 | 18,6 | 6,2 | 10,1 | 8,0 B | 9,2 | 218 |
 Granite 4.2 8B 💡 🏠 | 16,9 | 5,3 | 26,8 | 8,0 B | 1,9 | 36 |
| Gemma 4 12B 💡 🏠 | 14,6 | 12,7 | 15,3 | 12,0 B | 50,9 | 124 |
| Gemma 4 12B 💡 🏠 | 11,0 | 7,2 | 9,8 | 12,0 B | 51,1 | 752 |
| Gemma 4 31B 💡 🏠 | 10,0 | 17,7 | 29,6 | 31,0 B | 59,4 | 548 |
| Gemma 4 12B 💡 🏠 | 9,0 | 9,8 | 12,4 | 12,0 B | 53,2 | 216 |
| Qwen3.8 27B 💡 🏠 | 8,9 | 17,7 | 26,5 | 27,0 B | 45,6 | 546 |
 Muse Glimmer 30B 💡 🏠 | 8,8 | 18,2 | 20,0 | 29,6 B | 64,5 | 394 |
| Qwen3.8 27B 💡 🏠 | 8,4 | 30,0 | 38,7 | 27,0 B | 60,8 | 498 |
| Muse Glimmer 30B 💡 🏠 | 8,0 | 21,1 | 22,9 | 29,6 B | 60,8 | 397 |
| Granite 4.2 30B 💡 🏠 | 7,6 | 17,7 | 52,1 | 30,0 B | 5,9 | 423 |
| Qwen3.6 27B 💡 🏠 | 7,5 | 28,6 | 37,3 | 27,0 B | 55,0 | 190 |
| Qwen3.8 27B 💡 🏠 | 7,0 | 23,4 | 32,1 | 27,0 B | 59,4 | 504 |
| Granite 4.2 30B 💡 🏠 | 6,6 | 24,0 | 58,4 | 30,0 B | 7,4 | 397 |
| Gemma 4 31B 💡 🏠 | 5,8 | 26,4 | 38,4 | 31,0 B | 64,6 | 527 |
| Qwen3.6 27B 💡 🏠 | 5,2 | 16,5 | 25,3 | 27,0 B | 38,3 | 588 |
| Granite 4.2 30B 💡 🏠 | 4,9 | 31,1 | 65,5 | 30,0 B | 5,4 | 447 |
| Gemma 4 31B 💡 🏠 | 4,8 | 33,8 | 45,8 | 31,0 B | 68,9 | 316 |
Keine Messung entspricht diesen Filtern.
Median der Token pro Sekunde über die auf dieser Maschine erzeugten gültigen Benchmark-Antworten, Reasoning-Token eingeschlossen; Datei und Speicher wie auf der Seite Lokale KI; Bewertung aus der Hauptrangliste dieser Ausgabe. Siehe auch: Community-Messungen für den Ryzen AI Max+ 395.
Die Faustregel: Bandbreite, nicht Rechenleistung
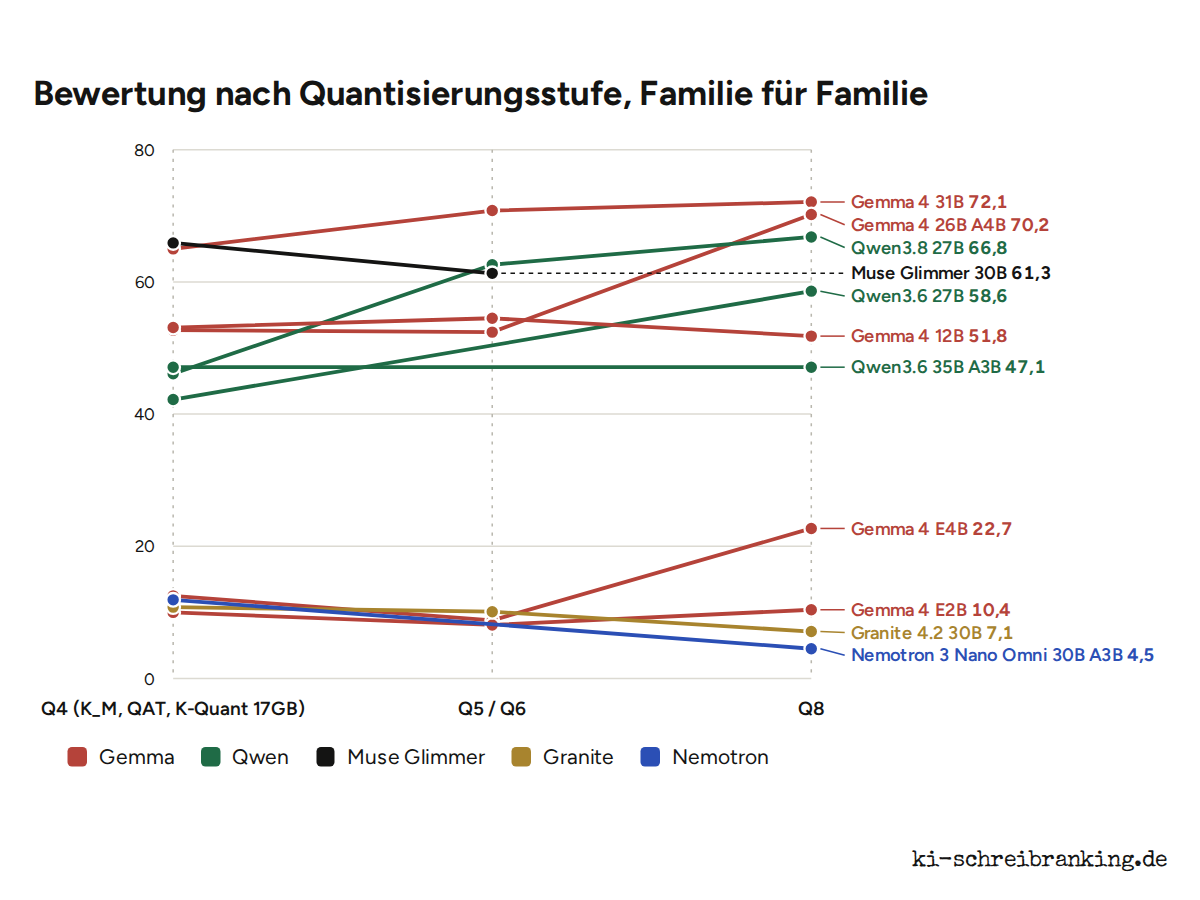
Beim Generieren muss für jedes Token einmal das gesamte aktive Gewicht gelesen werden. Auf Strix Halo liefert der Speicher rund 256 GB pro Sekunde: Ein dichtes Modell mit 30 GB (Qwen3.8 27B in Q8_0) kann daher kaum mehr als etwa 8,5 Token pro Sekunde erreichen, gemessen sind es 8,4. Gemma 4 31B Q8_0 mit 33,8 GB landet bei 4,8. Eine Q4-Quantisierung halbiert ungefähr die Datei und kann das Tempo verdoppeln, bei Gemma 4 31B von 4,8 Token pro Sekunde in Q8_0 auf 10 in QAT-Q4_0, zu dem Preis, den unsere Quantisierungsanalyse dokumentiert.
Mixture-of-Experts-Modelle entgehen der Regel: Sie speichern viele Parameter, aktivieren aber je Token nur wenige. Gemma 4 26B A4B liest 4 Milliarden Parameter je Token und erreicht in Q8_0 40 Token pro Sekunde; Qwen3.6 35B A3B 22; Ling 3.0 Flash, eine 77-GB-Datei, schafft noch 30 Token pro Sekunde, weil jeweils nur 5 Milliarden Parameter arbeiten. Auf dieser Hardware ist der beste Kompromiss zum Schreiben ein Experten-Modell in Q8, nicht ein dichtes Modell in Q4.
Was 128 GB wirklich kaufen
Speicher, nicht Tempo. Nemotron 3 Super 120B in Q4_K_M ist eine 86-GB-Datei, die keine Grafikkarte für Privatanwender fasst; hier läuft sie mit 21 Token pro Sekunde. Ling 3.0 Flash mit 77 GB lädt mit Reserve für langen Kontext. Ein dichtes 70-Milliarden-Modell in Q4 passt ebenfalls, ist mit rund 5 Token pro Sekunde aber ein Werkzeug für Geduldige. Benchmarks aus der Community geben Apples M4 Max etwa das doppelte Decodier-Tempo von Strix Halo auf solchen dichten 70B-Modellen, zu ungefähr dem doppelten Preis; bei Experten-Modellen ist der Abstand deutlich kleiner.
Wie gemessen wurde
LM Studios llama.cpp-Engine, Standardeinstellungen, dieselben 240 Aufgaben je Sprache wie im übrigen Ranking, Reasoning aktiviert, wo das Modell es unterstützt. Der Median gilt über vollständige Antworten, schließt also Reasoning-Phase und Prompt-Verarbeitung ein; kurze Aufgaben mit langem Reasoning drücken die Zahl, genau wie ein Schreiber es erlebt. Die Geschwindigkeiten hängen von Kontextlänge, Backend (Vulkan oder ROCm) und Treiberversionen ab: Lesen Sie sie als Rangfolge der Modelle untereinander auf einer Maschine, nicht als absolutes Versprechen. Die Qualität stammt aus der Rangliste lokaler KI, die dieselben Dateien verwendet.
Quellen und weitere Lektüre
- Benchmarks der Strix-Halo-Backends (AMD Strix Halo Toolboxes) (llama.cpp auf ROCm und Vulkan, viele Modelle)
- Framework-Community: LLM-Leistungstests des Ryzen AI Max+ 395
- Level1Techs: LLM-Benchmark-Ergebnisse auf Strix Halo