Ein Modell, vier Sprachen: Die ersten sechs bleiben, das Mittelfeld wandert um vierzig Plätze
91 Modelle sind auf Englisch, Französisch, Deutsch und Spanisch nach demselben Verfahren eingestuft. Am 19. September war Claude Fable 5 in allen vier Sprachen Dritter, Claude Opus 5 auf Deutsch Erster. Darunter war GLM 5.3 Flash auf Englisch Zehnter und auf Deutsch 54., und die beste lokale Datei ist in jeder Sprache eine andere: auf Deutsch Gemma 4 31B.
Die vier Ausgaben dieses Rankings teilen sich dieselben Modelle, dieselben Juroren und dasselbe Verfahren. Nur die Aufgaben ändern sich: 240 je Sprache, jeweils in dieser Sprache verfasst. Wenn ein Modell auf Englisch Zehnter und auf Deutsch 54. ist, liegt der Unterschied also nicht an der Methode. Er liegt am Modell.
91 Modellvarianten hatten am 19. September 2026 in allen vier Sprachen eine veröffentlichte Bewertung. Text und Grafiken dieses Artikels geben diesen Stand wieder, veröffentlicht am 20. September; die aktuelle Rangliste kann inzwischen abweichen, vor allem an der Spitze, wo seither neue Modelle hinzugekommen sind. So weit wanderten die Modelle damals.
Die ersten sechs bewegen sich kaum: Claude Fable 5 war überall Dritter, Claude Opus 5 auf Deutsch Erster
Die Modelle, die in jeder Sprache ihren Rang halten
Rang in jeder Ausgabe der sechs Modelle, deren Rang sich zwischen den vier Sprachen am wenigsten bewegt. Rang 1 steht oben.
Als Datentabelle anzeigen
| Modell | Englisch | Französisch | Deutsch | Spanisch |
|---|---|---|---|---|
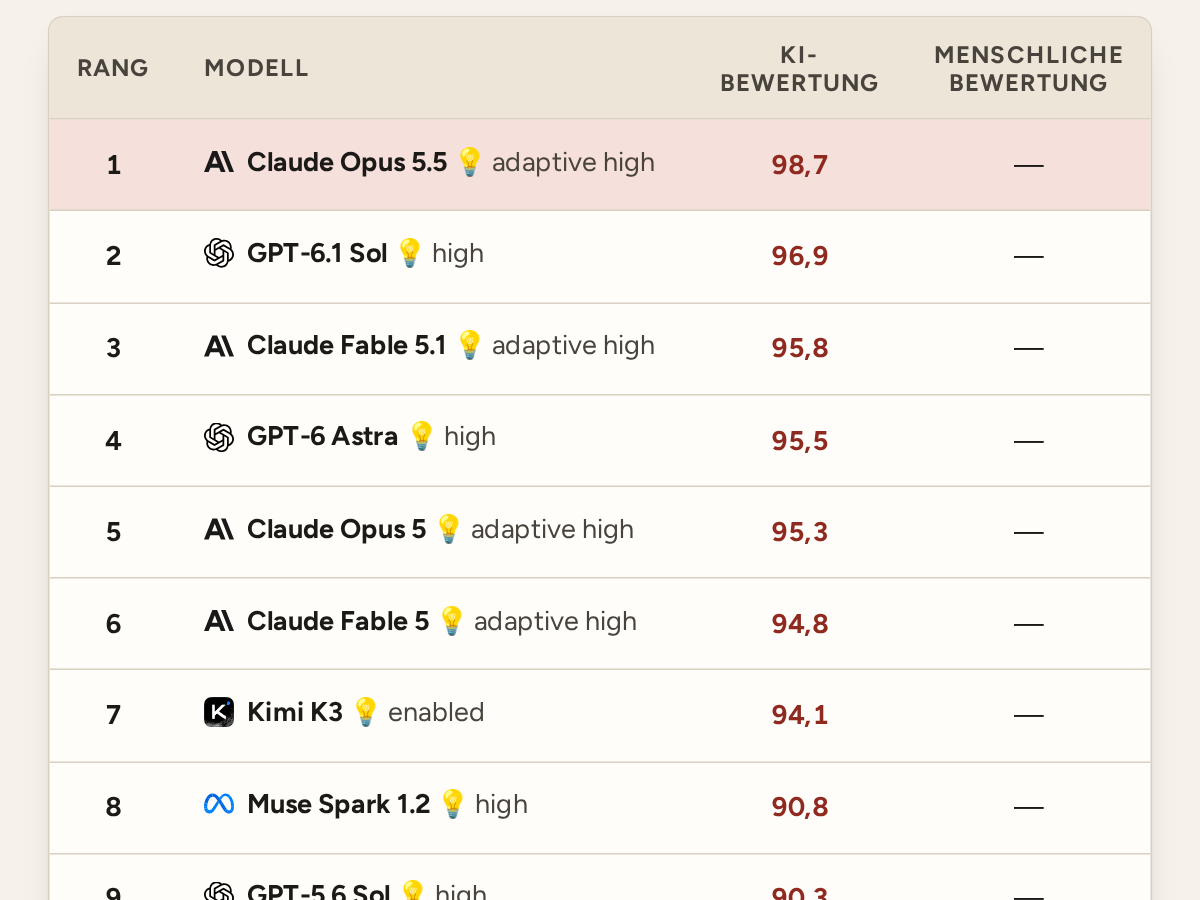
| Claude Fable 5 | 3 | 3 | 3 | 3 |
| Claude Opus 5 | 2 | 1 | 1 | 1 |
| Claude Fable 5.1 | 4 | 2 | 2 | 1 |
| GPT-5.6 Sol | 9 | 9 | 6 | 9 |
| GPT-6 Astra | 5 | 6 | 4 | 7 |
| Claude Opus 4.8 | 7 | 4 | 8 | 5 |
Sechs Modelle verlassen in keiner Sprache die ersten neun Plätze: Claude Fable 5, Claude Opus 5, Claude Fable 5.1, GPT-6 Astra, Claude Opus 4.8 und Kimi K3. Kimi K3 ist das einzige Modell mit offenen Gewichten darunter; damals auf Englisch Erster, auf Deutsch Fünfter. GPT-5.6 Sol gehört ebenfalls zum Club, damals in drei Sprachen Neunter und auf Deutsch Sechster.
Die Bewertungen erzählen dieselbe Geschichte mit einer Nuance: Claude Opus 5 kam auf Deutsch auf 98,0 und auf Englisch auf 93,7. Das heißt, dass das deutsche Feld ihm mehr Raum zum Dominieren lässt, nicht, dass es besser Deutsch als Englisch schreibt. Bewertungen sind nur innerhalb einer Sprache vergleichbar.
Unterhalb der Spitze kann dasselbe Modell in einer Sprache Zehnter und in einer anderen 54. sein
Ein Modell, vier Ränge
Rang in jeder Ausgabe der sechs Modelle mit der größten Spannweite, unter den 91 Modellen mit Rang in allen vier Sprachen. Rang 1 steht oben.
Als Datentabelle anzeigen
| Modell | Englisch | Französisch | Deutsch | Spanisch |
|---|---|---|---|---|
| GLM 5.3 Flash | 10 | 27 | 54 | 44 |
| Qwen3.8 27B Q4_K_M | 27 | 17 | 58 | 54 |
| Ling 3.0 Flash Q4_K_M | 66 | 35 | 76 | 65 |
| Grok 4.6 | 25 | 60 | 52 | 21 |
| Hy3 | 15 | 43 | 25 | 51 |
| Seed 2.1 Turbo ↯ | 57 | 28 | 61 | 43 |
GLM 5.3 Flash ist auf Englisch ein Top-Ten-Modell und auf Deutsch in der unteren Hälfte. Grok 4.6 ist auf Englisch und Spanisch stark, auf Französisch und Deutsch schwach. Hy3 ist auf Englisch gut, überall sonst mittelmäßig. Das sind keine Stichprobenzufälle: Jedes Modell hat je Sprache zwischen 1.000 und 1.800 gewertete Duelle, und die Konfidenzintervalle sind wenige Punkte breit.
Lokale Modelle zeigen dasselbe Muster mit einer Pointe. Qwen3.8 27B in Q4_K_M war auf Französisch das beste lokale Modell, Platz 17 insgesamt, und auf Deutsch eines der schwächsten, Platz 58. Dieselbe Datei, dieselbe Maschine, dieselbe Reasoning-Einstellung. Was Qwen über Französisch gelernt hat, hat es über Deutsch nicht gelernt.
Die beste lokale Datei ist in jeder Sprache eine andere, und auf Spanisch und Deutsch ist der Abstand zur Cloud am größten
Bestes Modell gegen bestes lokales Modell
Bewertung des Spitzenreiters jeder Ausgabe und ihres besten lokal betriebenen Modells. Bewertungen sind nur innerhalb einer Sprache vergleichbar.
- Bestes Modell
- Bestes lokales Modell
Als Datentabelle anzeigen
| Bestes Modell | Bestes lokales Modell | |
|---|---|---|
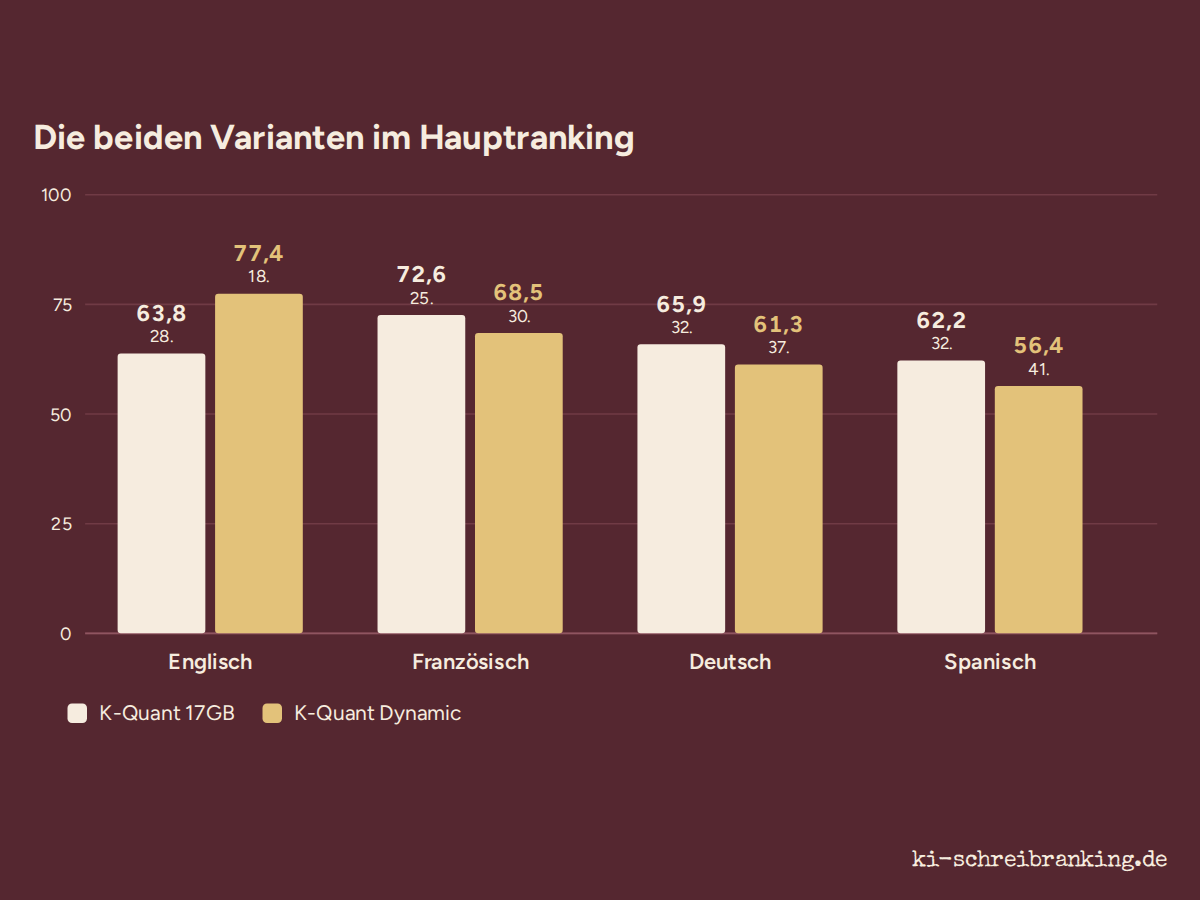
| Englisch | Kimi K3, 93,8 | Muse Glimmer 30B K-Quant Dynamic, 77,4 (18.) |
| Französisch | Claude Opus 5, 99,5 | Qwen3.8 27B Q4_K_M, 76,6 (17.) |
| Deutsch | Claude Opus 5, 98,0 | Gemma 4 31B Q8_0, 72,1 (24.) |
| Spanisch | Claude Fable 5.1, 98,3 | Qwen3.8 27B Q8_0, 70,4 (23.) |
Gemma 4 31B Q8_0 gewann das lokale Feld auf Deutsch, Muse Glimmer 30B K-Quant Dynamic auf Englisch, Qwen3.8 27B auf Französisch (Q4_K_M) und auf Spanisch (Q8_0). Wer nur ein Ranking liest, käme nie darauf. Auf Deutsch trennten 26 Punkte das beste lokale Modell, Gemma 4 31B Q8_0 mit 72,1, vom besten Cloud-Modell, Claude Opus 5 mit 98,0; auf Englisch waren es 16, auf Französisch 23, auf Spanisch 28. Je weiter vom Englischen entfernt, desto mehr büßt ein lokales Setup ein.
Was daraus folgt
Ein englisches Ranking zu lesen, um ein Modell fürs Deutsche auszuwählen, ist bei etwa einem Drittel des Feldes ein Fehler. Die geschlossenen Spitzenmodelle sind in jeder getesteten Sprache sicher. Darunter gilt: die deutsche Ausgabe lesen, und wer lokal arbeitet, prüft die konkrete Quantisierung. Die Datei, die in einer Sprache gewinnt, kann in der nächsten verlieren.
Fazit
Die Spitzenmodelle sind in jeder Sprache Spitze, das übrige Feld nicht. Wer auf Deutsch schreibt, wird von einem englischen Ranking bei etwa einem Drittel der Modelle in die Irre geführt: Lesen Sie die deutsche Ausgabe, und wer Modelle lokal betreibt, prüft dort auch die konkrete Quantisierung.