Muse Glimmer 30B schreibt ordentlich Deutsch, doch Gemma 4 31B und die kleine 17GB-Variante schlagen die große
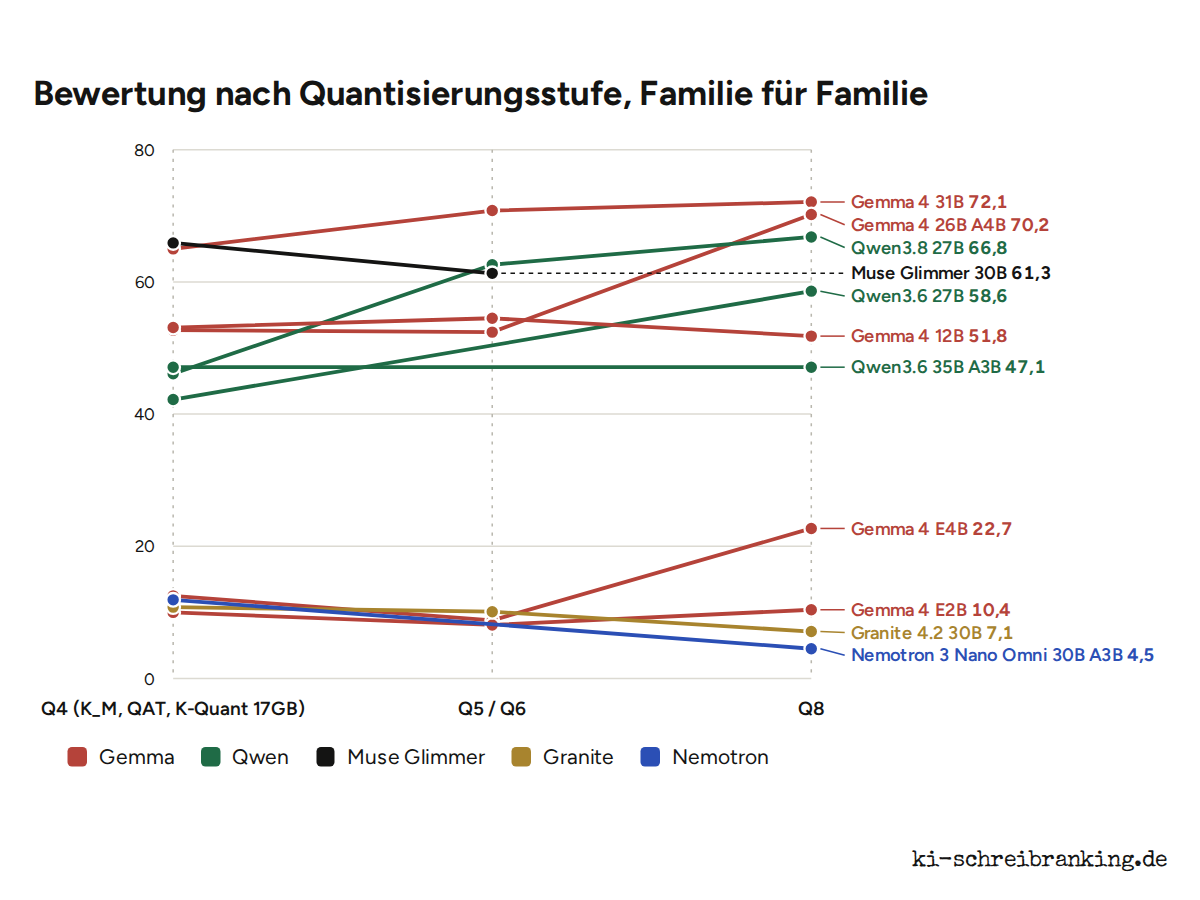
Metas offenes Modell liegt auf Deutsch mit 65,9 Punkten in der K-Quant-17GB-Variante auf Platz 32 des Rankings, die größere Dynamic-Variante mit 61,3 auf Platz 37. Im direkten Duell verliert Dynamic 15 von 26 Runden. Und Gemma 4 31B Q8_0, das beste lokale Modell auf Deutsch, gewinnt gegen beide Muse-Varianten.
Das Urteil zuerst. Muse Glimmer 30B ist ein brauchbarer lokaler Generalist, der auf eigener Hardware ordentliche Prosa liefert, ohne Umweg über die Cloud. Im August, mit 100 Urteilen, nannten wir es interessant. Mit 1.500 gewerteten Duellen je Variante und Sprache ist es heute auf Englisch das beste lokale Modell und auf Deutsch, Französisch und Spanisch unter den ersten fünf lokalen. Ein Spitzenmodell ist es weiterhin nicht: Die besten Cloud-Modelle erreichen in jeder Sprache 94 bis 99 Punkte, Muse Glimmer 56 bis 77.
Welche Datei laden: Auf Deutsch führt 17GB mit fünf Punkten, auf Englisch Dynamic mit 14
Die beiden Varianten im Hauptranking
Bewertung jeder Variante gegen das gesamte Feld der Ausgabe; Rang klein gedruckt.
- K-Quant 17GB
- K-Quant Dynamic
Als Datentabelle anzeigen
| K-Quant 17GB | K-Quant Dynamic | |
|---|---|---|
| Englisch | 63,8 (28.) | 77,4 (18.) |
| Französisch | 72,6 (25.) | 68,5 (30.) |
| Deutsch | 65,9 (32.) | 61,3 (37.) |
| Spanisch | 62,2 (32.) | 56,4 (41.) |
Meta liefert zwei offizielle Textquantisierungen. Im deutschen Ranking, in dem jede Variante 55 andere lokale und Cloud-Modelle getroffen hat, kommt K-Quant 17GB auf 65,9 Punkte und Platz 32; K-Quant Dynamic auf 61,3 und Platz 37. Auf Französisch und Spanisch dieselbe Reihenfolge. Auf Englisch dreht sie sich um, und Dynamic führt mit 14 Punkten.
Das direkte Duell sagt dasselbe: Dynamic verliert auf Deutsch 15 von 26 Runden
Dynamic gegen 17GB im direkten Duell
Ausgang der 26 direkten Duelle je Ausgabe, aus Sicht der Dynamic-Variante.
- Siege von Dynamic
- Unentschieden
- Siege von 17GB
Als Datentabelle anzeigen
| Siege von Dynamic | Unentschieden | Siege von 17GB | Anteil Dynamic | |
|---|---|---|---|---|
| Englisch | 14 | 5 | 7 | 63,5 % |
| Französisch | 10 | 0 | 16 | 38,5 % |
| Deutsch | 10 | 1 | 15 | 40,4 % |
| Spanisch | 8 | 2 | 16 | 34,6 % |
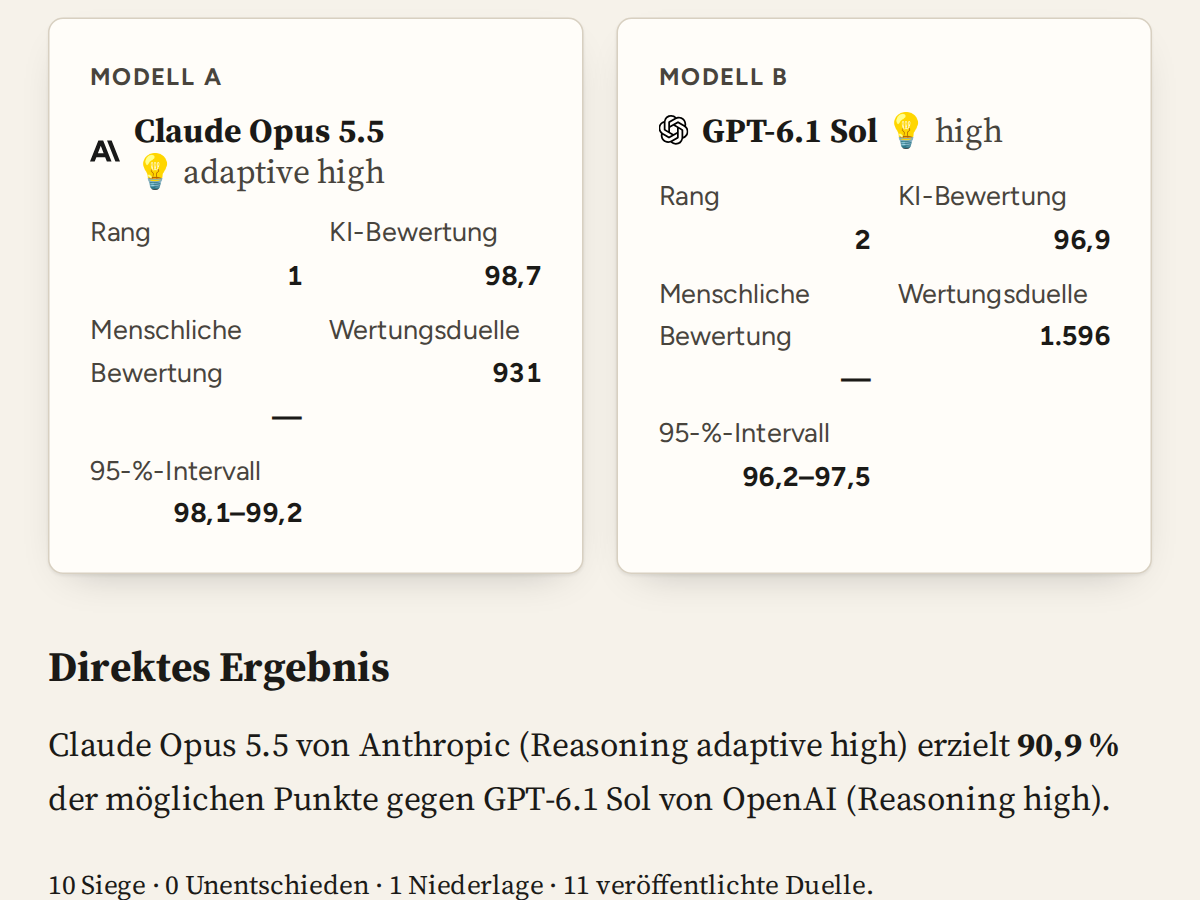
Die beiden Varianten sind je Sprache 26-mal gegeneinander angetreten. Auf Deutsch gewinnt Dynamic 10 Runden, verliert 15, einmal unentschieden. Auf Französisch und Spanisch verliert es 16 von 26, nur auf Englisch gewinnt es, 14 zu 7. Zwei unabhängige Methoden, Ranking und Duell, stimmen in jeder Sprache überein. Eine Erklärung haben wir nicht: Meta gibt für Dynamic die geringere mittlere Verschlechterung an, und in drei von vier Sprachen bevorzugen unsere Juroren die Datei mit der angeblich stärkeren.
Gegen die lokalen Konkurrenten: Nemotron und Qwen 3.6 geschlagen, gegen Gemma 4 31B verloren
Muse Glimmer gegen fünf lokale Konkurrenten
Punkteanteil jeder Muse-Glimmer-Variante im direkten Duell mit dem Konkurrenten (Sieg zählt 1, Unentschieden ½); rund 20 Duelle je Balken.
- K-Quant 17GB
- K-Quant Dynamic
Als Datentabelle anzeigen
| K-Quant 17GB | K-Quant Dynamic | |
|---|---|---|
| Gemma 4 31B Q8_0 | 45,2 % (21) | 52,4 % (21) |
| Qwen3.6 27B Q4_K_M | 57,9 % (19) | 63,2 % (19) |
| Qwen3.6 35B A3B Q4_K_M | 66,7 % (21) | 65,0 % (20) |
| Qwen3.8 27B Q4_K_M | 71,4 % (14) | 50,0 % (14) |
| Nemotron 3 Nano 30B A3B Q4_K_M | 100,0 % (21) | 90,5 % (21) |
Auf Deutsch schlägt Muse Glimmer Nemotron 3 Nano fast immer und holt gegen die beiden Qwen-3.6-Varianten 58 bis 67 % der Punkte. Gemma 4 31B Q8_0 dreht den Spieß um: Es lässt beiden Muse-Varianten nur 45 und 52 % der Punkte, was zum deutschen Ranking passt, wo Gemma 4 31B das beste lokale Modell ist. Qwen3.8 27B ist der jüngste Gegner; gegen ihn holt 17GB 71 % der Punkte, Dynamic 50 %, auf je 14 Duellen.
Was es ist, was es kostet, und ob man damit schreiben sollte
Meta Superintelligence Labs hat Muse Glimmer 30B am 10. August 2026 als offenes „agentisches“ Modell veröffentlicht; zur Prosaqualität macht Meta keine Aussage. Es ist ein dichter Transformer mit rund 29,6 Milliarden Parametern, davon 1,8 Milliarden in einem separaten Bild-Encoder, mit 131.072 Token Kontext und Wissensstand 4. Januar 2026. Die Trainingsdaten sollen mehr als hundert Sprachen umfassen, eine Liste veröffentlicht Meta nicht, was unsere Ergebnisse je Sprache relevant macht.
Die 17GB-Variante wiegt mit Bild-Encoder 18,2 GB und braucht mit vollem 128K-Kontext etwa 20 GB; Dynamic wiegt 21,1 GB und braucht etwa 23 GB. Diese Werte gelten mit F16-Cache und aktiver Flash Attention, berechnet wie auf der Seite Lokale KI. Wer nur Text schreibt, kann den Bild-Encoder (1,4 GB) weglassen; der optionale spekulative Drafter (1,6 GB) ist nicht eingerechnet. Beide Varianten sind auf unserer Strix-Halo-Maschine langsam, 8 bis 9 Token pro Sekunde einschließlich Reasoning-Token, wo Gemma 4 26B A4B 20 bis 40 liefert.
Wer auf Deutsch schreibt, ist mit Gemma 4 31B Q8_0 oder Q6_K besser bedient: mehr Punkte, weniger Speicher in Q6. Wer Muse Glimmer trotzdem will, nimmt 17GB. Dynamic lohnt nur mit 32 GB und überwiegend englischen Texten.
Fazit
Muse Glimmer 30B ist ein ernstzunehmender lokaler Schreiber mit einer Eigenheit: Seine beiden offiziellen Varianten liegen je nach Sprache in anderer Reihenfolge. Auf Deutsch führt 17GB mit fünf Punkten und gewinnt das Duell; auf Englisch gewinnt Dynamic mit 14 Punkten. Mit 24 GB nehmen Sie 17GB; Dynamic lohnt nur mit 32 GB und überwiegend englischen Texten. Fürs Deutsche ist Gemma 4 31B die bessere Wahl. Ein Spitzenmodell ist es nicht: Die besten Cloud-Modelle kommen auf 94 bis 99, Muse Glimmer auf 56 bis 77.