Bevorzugen KI-Juroren das eigene Modell? Zwei von fünf tun es, um bis zu 15 Punkte
Urteilt GPT-5.6 Sol über ein Duell, in dem GPT-5.6 Sol selbst antritt, holen die eigenen Texte 94 % der Punkte; unter den anderen Juroren sind es 78 %. Claude Opus 5 neigt in dieselbe Richtung, schwächer. Die beiden Claude-Fable-Juroren machen das Gegenteil und bewerten das eigene Modell strenger als die anderen.
Stand 19. September 2026. Ein Nachtrag vom 1. Oktober 2026 am Ende ergänzt dieselbe Messung für die seit dem 23. September aktiven Juroren.
Jeder Juror dieses Rankings bekommt zwei anonyme Texte und wählt den besseren. Anonym für den Juror, nicht für uns: Wir wissen, wer welchen Text geschrieben hat. Deshalb können wir eine Frage stellen, die der Juror sich selbst nicht stellen kann: Ändert sich das Urteil, wenn einer der beiden Texte vom eigenen Modell stammt?
Bei zwei Juroren tut es das. Die Grafik vergleicht für jeden Juror den Punkteanteil, den sein Modell holt, wenn er selbst entscheidet, mit dem Anteil, den dasselbe Modell unter allen anderen Juroren holt. Ein Sieg zählt einen Punkt, ein Unentschieden einen halben. Datenbasis: alle veröffentlichten deutschen Duelle bis zum 19. September 2026, rund 64.000 Urteile.
GPT-5.6 Sol gibt eigenen Texten 15 Punkte mehr, Claude Opus 5 acht
Das eigene Modell jedes Jurors, unter eigenen Urteilen und unter denen der anderen
Punkteanteil des Modells (Sieg zählt 1, Unentschieden ½), wenn es selbst als Juror urteilt und wenn die anderen Juroren entscheiden.
- Unter dem eigenen Juror
- Unter den anderen Juroren
Als Datentabelle anzeigen
| KI-Juror | Unter dem eigenen Juror | Unter den anderen Juroren | Hausbonus | n |
|---|---|---|---|---|
| GPT-5.6 Sol | 93,5 % | 78,4 % | +15,1 | 1.034 |
| Claude Opus 5 | 98,0 % | 89,7 % | +8,3 | 817 |
| Muse Spark 1.3 | 84,1 % | 79,3 % | +4,8 | 138 |
| Claude Fable 5 | 91,3 % | 92,8 % | −1,5 | 897 |
| Claude Fable 5.1 | 90,7 % | 93,0 % | −2,3 | 198 |
GPT-5.6 Sol ist der deutlichste Fall: 93,5 % der Punkte, wenn Sol urteilt, 78,4 %, wenn jemand anderes urteilt, über gut tausend selbst gerichtete Duelle. Claude Opus 5 neigt in dieselbe Richtung, mit kleinerem Abstand: 98,0 % gegen 89,7 %. Muse Spark 1.3 folgt mit 84,1 % gegen 79,3 % auf einer Stichprobe von 138 Duellen, zu klein für eine sichere Aussage.
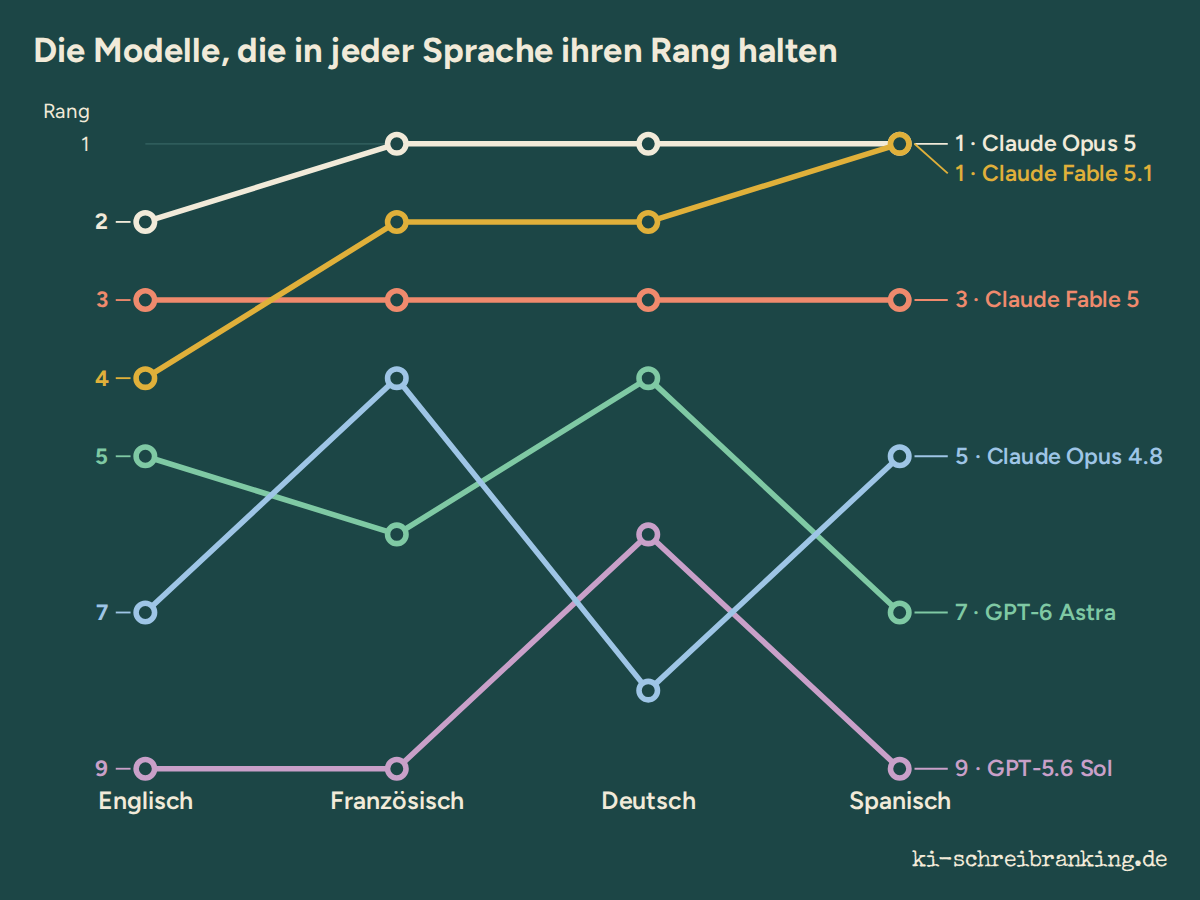
Dasselbe Muster zeigt sich auf Englisch, Französisch und Spanisch, mit einem Sol-Bonus zwischen 15 und 20 Punkten. Es ist kein Artefakt des deutschen Korpus.
Claude Fable 5 und Claude Fable 5.1 bewerten das eigene Modell strenger
Die beiden Fable-Juroren gehen den umgekehrten Weg. Unter ihren eigenen Urteilen holen ihre Texte weniger Punkte als unter den anderen: 91,3 % gegen 92,8 % bei Fable 5, 90,7 % gegen 93,0 % bei Fable 5.1. Ein Abschlag von ein bis zwei Punkten, wieder in allen vier Sprachen. Was auch immer der Grund ist, schmeicheln tun sie sich nicht.
Warum der Bonus zählt: zwei Juroren liefern 85 % aller Urteile
Der Bonus eines Jurors mit kleinem Anteil würde im gemeinsamen Ranking untergehen. Hier geht das nicht: Claude Opus 5 und GPT-5.6 Sol liefern 85 % aller Urteile. Rund 800 Opus-über-Opus- und 1.000 Sol-über-Sol-Duelle gehen zusammen mit allen anderen in die Bradley-Terry-Anpassung ein, und sie ziehen.
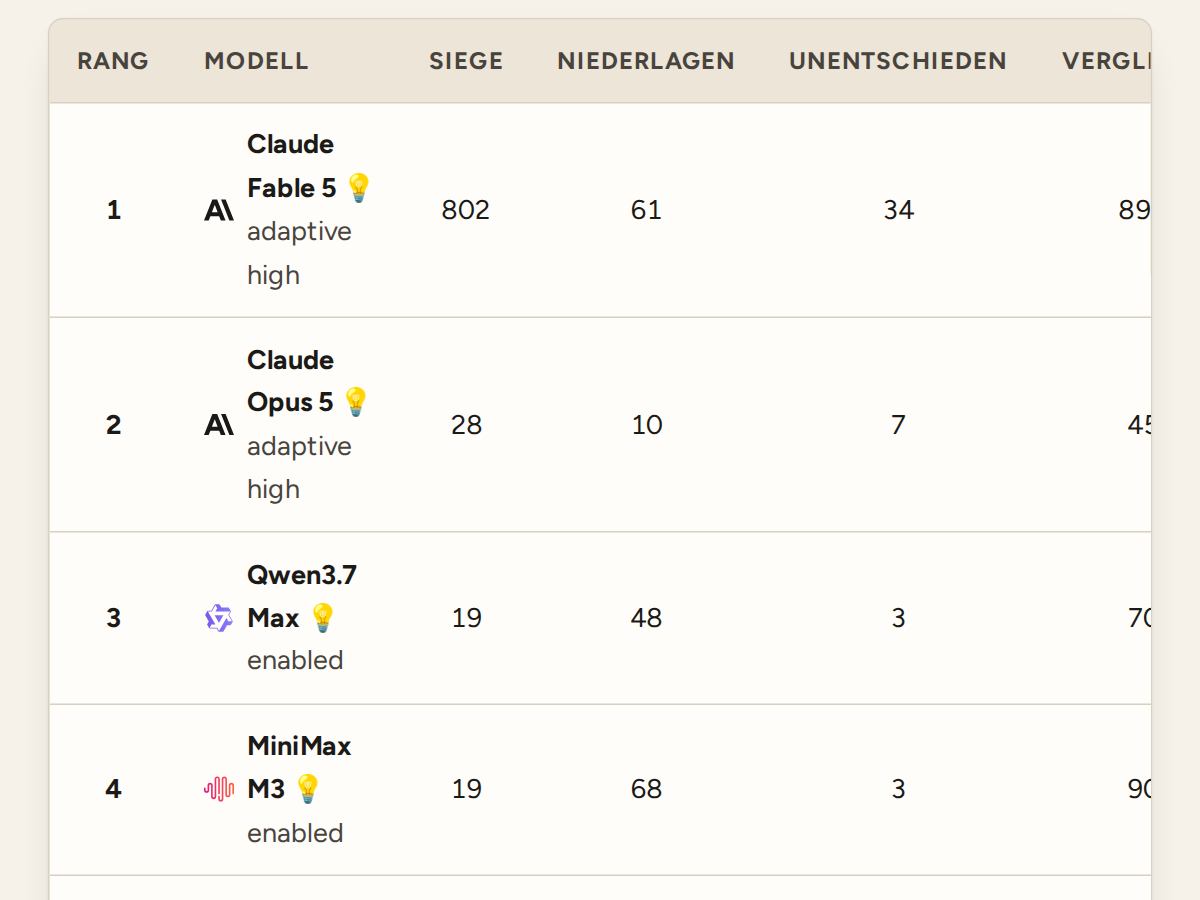
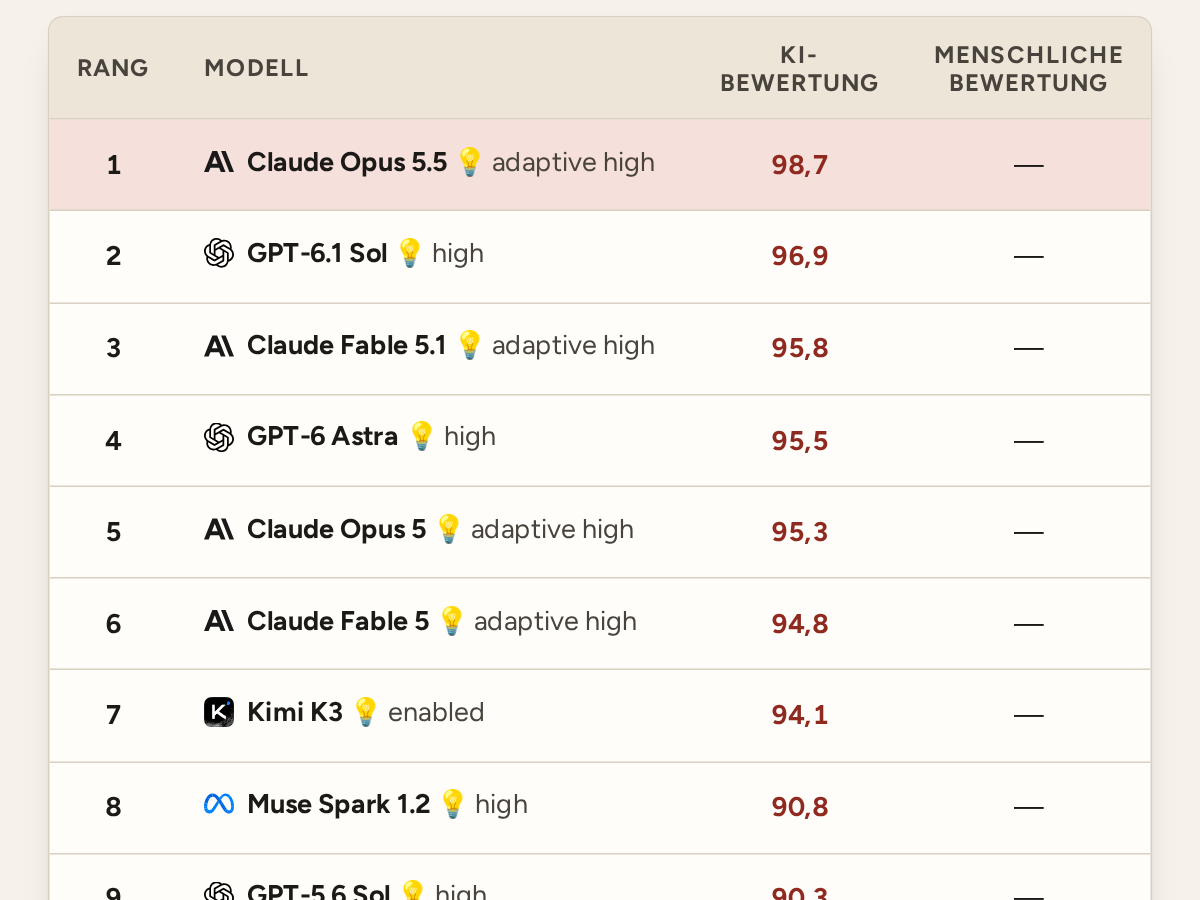
In den Tabellen je Juror war der Effekt am 19. September sichtbar: GPT-5.6 Sol setzte das eigene Modell auf Platz zwei, wenn es allein urteilte; im gemeinsamen Ranking stand es auf Platz sechs. Claude Opus 5 war überall Erster, allein wie gemeinsam, sodass sein Bonus an der Spitze wenig änderte, die Bewertung aber trotzdem aufblähte.
Warum wir noch nicht von Verzerrung sprechen
Zwei Vorbehalte halten uns von einem Urteil ab. Erstens sind die Duelle nicht dieselben: Unter dem eigenen Juror trifft ein Modell eine andere Gegnermischung als unter den anderen, und die Mischung verändert den erwarteten Anteil. Sols Abstand ist zu groß, um ganz daran zu liegen, teilweise aber schon. Zweitens sind „die anderen Juroren“ kein neutrales Instrument: Bei Sol sind das vor allem Opus 5, bei Opus 5 vor allem Sol. Ist einer streng mit dem anderen, landet diese Strenge in derselben Zeile.
Der saubere Test ist eine kontrollierte Stichprobe, dieselben Paare von jedem Juror beurteilt, plus ein Ranking ohne selbst gerichtete Duelle. Beides ist geplant, aber noch nicht veröffentlicht; bis dahin ergänzen datierte Nachträge wie der folgende die Zahlen.
Nachtrag (1. Oktober 2026)
Seit dem 23. September urteilen Claude Opus 5.5 und GPT-6 Sol, seit dem 8. September Muse Spark 1.3. Auch diese neuen Juroren beurteilen Paare, in denen ihr eigenes Modell antritt; die Urheber der Texte bleiben ihnen dabei verborgen. Dieselbe Rechnung wie oben, mit den deutschen Daten vom 1. Oktober 2026:
- GPT-6 Sol gibt dem eigenen Modell 92,0 % der Punkte in 436 selbst gerichteten Duellen; unter den anderen Juroren holt GPT-6 Sol 85,3 %. Ein Bonus von knapp sieben Punkten, weniger als halb so viel wie die 15 Punkte seines Vorgängers GPT-5.6 Sol.
- Claude Opus 5.5 gibt dem eigenen Modell 98,9 % der Punkte in 606 Duellen, die anderen Juroren 98,5 %. Bei einem Modell, das fast jedes Duell gewinnt, ist kein Bonus messbar: Mehr als 100 % gibt es nicht.
- Muse Spark 1.3 kommt auf 84,3 % in 254 Duellen, gegen 80,8 % unter den anderen Juroren. Ein Bonus von 3,5 Punkten, ähnlich wie am 19. September und weiterhin auf kleiner Stichprobe.
Die beiden Vorbehalte von oben gelten unverändert. Bei GPT-6 Sol sind „die anderen Juroren“ ausschließlich Claude Opus 5.5 und Muse Spark 1.3, und weil die drei Juroren nicht alle dieselben Paare sehen, trifft das Modell unter jedem von ihnen eine andere Gegnermischung.
Fazit
Selbstbevorzugung gibt es bei zwei Juroren, bei zwei anderen nicht. Weil Claude Opus 5 und GPT-5.6 Sol bis Mitte September 85 % aller Urteile lieferten, kann ihr Bonus die eigenen Modelle im Hauptranking um einige Plätze heben. Der nächste Schritt ist ein Ranking ohne selbst gerichtete Duelle, damit sichtbar wird, wie viel sich tatsächlich verschiebt.