Q4, Q6 oder Q8: Quantisierung kostet bei manchen Modellen nichts und bei anderen zwanzig Punkte
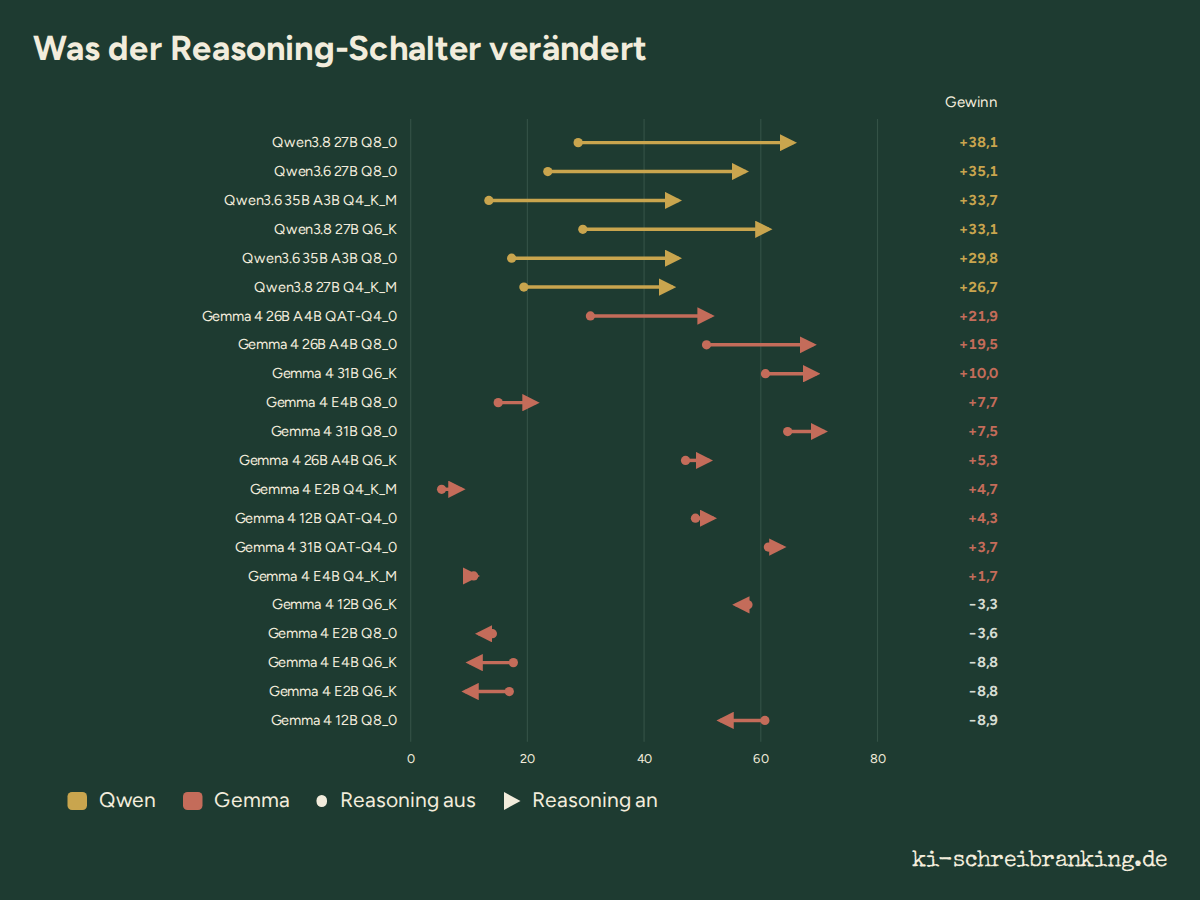
Dasselbe Modell, drei Dateien, drei Bewertungen. Auf Deutsch verliert Qwen3.8 27B 21 Punkte zwischen Q8_0 und Q4_K_M, Gemma 4 26B A4B 18 Punkte, während Gemma 4 31B in Q6 fast so gut schreibt wie in Q8 und Qwen3.6 35B A3B in Q4 und Q8 exakt gleich abschneidet. Eine Faustregel gibt es nicht, nur Messungen.
Quantisierung verkleinert ein Modell, indem sie seine Gewichte mit weniger Bits speichert. Ein Modell mit 27 Milliarden Parametern wiegt 29 GB in Q8_0 und 17 GB in Q4_K_M; das entscheidet darüber, ob es auf eine 32-GB-Karte passt. Jeder Ratgeber sagt, die kleinere Datei schreibe ein bisschen schlechter. Wir haben gemessen, wie viel schlechter, auf deutschen Aufgaben, mit denselben Blindduellen, aus denen das Ranking entsteht, rund 1.000 bis 1.800 je Variante. Die Bewertungen sind die des deutschen Rankings vom 19. September 2026: 50 bedeutet, dass eine Variante das Durchschnittsmodell in der Hälfte der Duelle schlägt.
Dasselbe Modell, drei Dateien, drei Bewertungen: Die Linien verlaufen nicht parallel
Bewertung nach Quantisierungsstufe, Familie für Familie
Bewertung jeder Variante mit eingeschaltetem Reasoning. Linien verbinden die Varianten einer Familie; 4-Bit-Dateien links, 8-Bit rechts.
- Gemma
- Qwen
- Muse Glimmer
- Granite
- Nemotron
Als Datentabelle anzeigen
| Modellfamilie | Q4 (K_M, QAT, K-Quant 17GB) | Q5 / Q6 | Q8 |
|---|---|---|---|
| Gemma 4 31B | 65,0 | 70,8 | 72,1 |
| Gemma 4 26B A4B | 52,7 | 52,4 | 70,2 |
| Qwen3.8 27B | 46,1 | 62,6 | 66,8 |
| Muse Glimmer 30B | 65,9 | 61,3 | — |
| Qwen3.6 27B | 42,2 | — | 58,6 |
| Gemma 4 12B | 53,1 | 54,5 | 51,8 |
| Qwen3.6 35B A3B | 47,1 | — | 47,1 |
| Gemma 4 E4B | 12,5 | 8,8 | 22,7 |
| Gemma 4 E2B | 10,0 | 8,1 | 10,4 |
| Granite 4.2 30B | 10,8 | 10,1 | 7,1 |
| Nemotron 3 Nano Omni 30B A3B | 11,9 | — | 4,5 |
Wäre Quantisierung eine feste Steuer, stiege jede Linie von links nach rechts um denselben Betrag. Tut sie nicht. Einige sind flach, zwei steigen steil, eine geht sogar leicht bergab. Das ist der ganze Befund; der Rest des Artikels geht die Linien ab.
Wo Quantisierung nichts kostet: Qwen3.6 35B und Gemma 4 12B
Qwen3.6 35B A3B, ein Mixture-of-Experts-Modell, erreicht in Q4_K_M und Q8_0 exakt 47,1; die 22-GB-Datei ist der 38-GB-Datei gleichwertig. Gemma 4 12B liegt mit seinen drei Varianten innerhalb von 2,7 Punkten, und die QAT-Datei mit 7 GB ist dabei. Gemma 4 31B verliert zwischen Q8_0 (72,1) und QAT-Q4_0 (65,0) sieben Punkte, bleibt aber in jeder Variante das beste lokale Modell der deutschen Ausgabe oder knapp dahinter.
Wo sie teuer ist: Qwen3.8 27B verliert 21 Punkte, Gemma 4 26B A4B 18
Auf Deutsch trifft es die beiden Modelle, die auf Englisch und Französisch als unempfindlich gelten. Qwen3.8 27B fällt von 66,8 in Q8_0 über 62,6 in Q6_K auf 46,1 in Q4_K_M. Gemma 4 26B A4B fällt von 70,2 in Q8_0 auf 52,7 in QAT-Q4_0 und 52,4 in Q6_K. Qwen3.6 27B verliert 16 Punkte zwischen Q8 und Q4. Wer Deutsch schreibt, sollte diese drei in Q8 laden oder ein anderes Modell wählen.
Q6 ist selten die Antwort
Über neun Familien ist Q6_K auf Deutsch nur einmal das Beste seiner Familie, bei Gemma 4 12B, und dort um einen Punkt. Es spart weniger Speicher als Q4 und hält selten die Qualität von Q8. Wer blind wählen muss, nimmt Q8, wenn es passt, und eine QAT- oder K-Quant-Q4-Datei, wenn nicht, und lässt Q6 aus.
Was in 16 und 24 GB passt, und was es an Punkten kostet
Dateigröße gegen Bewertung
Jede Variante der Tabelle: GGUF-Dateigröße und Bewertung. Die gestrichelten Linien markieren 16 GB und 24 GB Speicher.
- Gemma
- Qwen
- Muse Glimmer
- Nemotron
- Granite
Als Datentabelle anzeigen
| Modell | Dateigröße (GB) | Bewertung |
|---|---|---|
| Gemma 4 31B Q8_0 | 32,6 | 72,1 |
| Gemma 4 31B Q6_K | 25,2 | 70,8 |
| Gemma 4 26B A4B Q8_0 | 26,9 | 70,2 |
| Qwen3.8 27B Q8_0 | 29,0 | 66,8 |
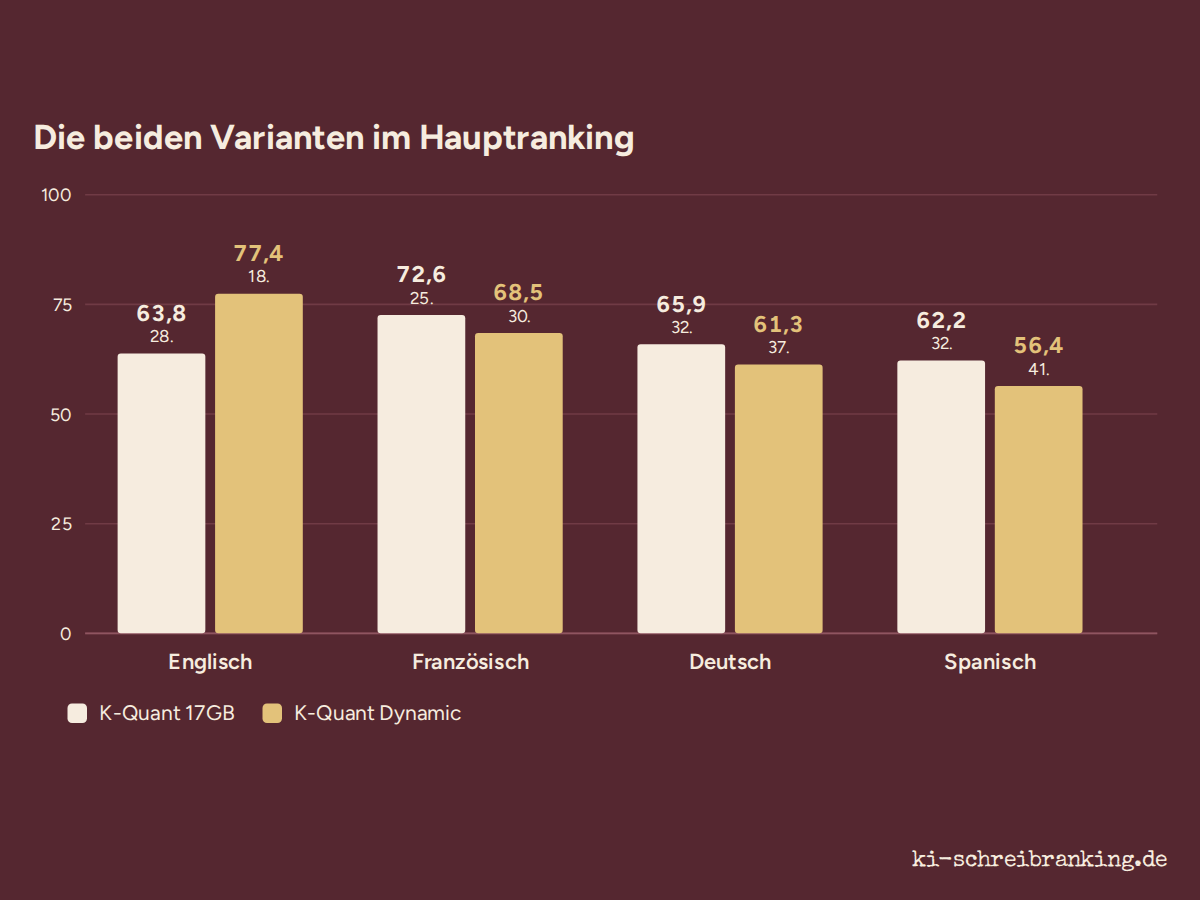
| Muse Glimmer 30B K-Quant 17GB | 16,8 | 65,9 |
| Gemma 4 31B QAT-Q4_0 | 17,7 | 65,0 |
| Qwen3.8 27B Q6_K | 22,4 | 62,6 |
| Muse Glimmer 30B K-Quant Dynamic | 19,7 | 61,3 |
| Qwen3.6 27B Q8_0 | 28,6 | 58,6 |
| Gemma 4 12B Q6_K | 9,8 | 54,5 |
| Gemma 4 12B QAT-Q4_0 | 7,0 | 53,1 |
| Gemma 4 26B A4B QAT-Q4_0 | 14,4 | 52,7 |
| Gemma 4 26B A4B Q6_K | 22,6 | 52,4 |
| Gemma 4 12B Q8_0 | 12,7 | 51,8 |
| Qwen3.6 35B A3B Q4_K_M | 21,2 | 47,1 |
| Qwen3.6 35B A3B Q8_0 | 36,9 | 47,1 |
| Qwen3.8 27B Q4_K_M | 16,8 | 46,1 |
| Qwen3.6 27B Q4_K_M | 16,5 | 42,2 |
| Gemma 4 E4B Q8_0 | 8,0 | 22,7 |
| Gemma 4 E4B Q4_K_M | 5,3 | 12,5 |
| Nemotron 3 Nano Omni 30B A3B Q4_K_M | 24,5 | 11,9 |
| Granite 4.2 30B Q4_K_M | 17,7 | 10,8 |
| Gemma 4 E2B Q8_0 | 5,0 | 10,4 |
| Granite 4.2 30B Q6_K | 24,0 | 10,1 |
| Gemma 4 E2B Q4_K_M | 3,4 | 10,0 |
| Gemma 4 E4B Q6_K | 6,2 | 8,8 |
| Gemma 4 E2B Q6_K | 3,8 | 8,1 |
| Granite 4.2 30B Q8_0 | 31,1 | 7,1 |
| Nemotron 3 Nano Omni 30B A3B Q8_0 | 33,6 | 4,5 |
Die gestrichelten Linien markieren die beiden üblichen Speichergrenzen, gemessen an der Dateigröße. Unter 16 GB ist der beste Schreiber Gemma 4 12B Q6_K mit 54,5 (9,8 GB), knapp vor Gemma 4 26B A4B QAT-Q4_0 mit 52,7 (14,4 GB). Unter 24 GB führt Muse Glimmer 30B K-Quant 17GB mit 65,9 (16,8 GB) vor Gemma 4 31B QAT-Q4_0 mit 65,0 (17,7 GB). Gemma 4 31B Q6_K mit 70,8, nur 1,3 Punkte hinter Q8_0, ist dagegen 25,2 GB groß und braucht schon eine 32-GB-Karte. Die Q8-Varianten rechts wiegen 27 bis 37 GB und bringen auf Deutsch, anders als auf Englisch, bei zwei Familien tatsächlich viel. Ob sich der Speicher lohnt, hängt hier vom Modell ab, nicht von der Regel.
Dieselbe Messung auf Englisch, Französisch und Spanisch gibt andere Antworten
Nichts davon überträgt sich. Auf Englisch ist die Q4-Datei von Qwen3.8 27B die beste ihrer Familie; auf Französisch bricht Gemma 4 12B in Q6 um 25 Punkte ein; auf Spanisch verliert Qwen3.8 27 Punkte zwischen Q8 und Q4. Jede Ausgabe dieses Artikels ist aus den Duellen ihrer Sprache geschrieben. Wer in einer davon schreibt, liest die.
Fazit
Quantisierung ist keine feste Steuer. Auf Deutsch kostet Q4 bei Qwen3.8 27B 21 Punkte und bei Gemma 4 26B 18, bei Gemma 4 31B nur 7 und bei Qwen3.6 35B gar nichts. Q6 ist selten das Beste seiner Familie. Nehmen Sie Q8, wenn es passt, und prüfen Sie die konkrete Datei in der Grafik, bevor Sie einer allgemeinen Prozentzahl glauben.